
Un equipo de agentes puede entregarte un informe impecable: bien estructurado, bien citado, con muy buena pinta. La pregunta que me interesa es menos vistosa: ¿ha encontrado los riesgos que yo sé que están ahí? Y justo detrás viene la incómoda: ¿con qué evidencia me lo creo antes de sentarme delante de un cliente?
Para responderla monté un banco de pruebas: diez pliegos sintéticos con quince defectos sembrados en cada uno, dos modelos —Claude Opus 5.5 y GPT-6 Astra—, dos CLI por modelo y tres formas de componer el equipo. En total, 120 ejecuciones.
Adelanto el resultado: un equipo fixed —predefinido y revisado— fue la política con mejor recall operacional en tres de los cuatro pares modelo/entorno. La mejor cifra la sacó Claude Opus 5.5 con fixed: 76,7 % en GitHub Copilot CLI y 76,0 % en Claude Code, las dos con diez de diez ejecuciones completadas. Entre esas dos CLI hay un defecto de diferencia sobre 150 oportunidades. Eso es un empate, y así lo voy a tratar.
Una aclaración de alcance:
Un equipo dinámico puede estar bien gobernado y un equipo fijo puede estar mal diseñado. Cómo se crean los agentes y cómo se gobierna su trabajo son cosas distintas. Aquí comparo tres políticas dentro del mismo protocolo, no metodologías enteras.
Mi tesis cabe en una línea: un harness que ordena el trabajo ayuda, pero no me exime de medir lo que sale de él. Y medir incluye comprobar que mi propio instrumento no me engaña.
1. De una licitación ficticia a diez dominios
Empecé con una sola licitación ficticia: la modernización del sistema comercial de una empresa de aguas, con quince defectos sembrados a propósito y dos controles.
Lo más valioso que saqué de ahí no fue un ranking. Fue aprender a desconfiar del instrumento. Un gate podía rechazar una referencia correcta solo porque la cláusula citada no tenía identificador. Un corrector demasiado permisivo podía premiar un informe que citaba media licitación sin discriminar. Si el instrumento falla, el ranking que produce no vale nada, por bonito que quede en una gráfica.
Para salir de un único pliego preparé 100 RFP sintéticas de dominios distintos: servicios sociales, movilidad, urbanismo, vivienda, energía, bibliotecas, transporte, deportes, mercados. agua, etc. Cada una con quince defectos y dos controles definidos antes de ejecutar nada.
100 RPfsdan variedad, pero siguen siendo documentos sintéticos. No representan todos los pliegos reales y no lo voy a vender así.
Pero solo ejecuté 10, más adelante lo explico.
2. Qué comparé exactamente
| Modelo solicitado | Grupo 01 | Grupo 02 |
|---|---|---|
| Claude Opus 5.5 | GitHub Copilot CLI | Claude Code |
| GPT-6 Astra | GitHub Copilot CLI | OpenAI Codex CLI |
La matriz es 10 RFP × 2 modelos × 2 entornos × 3 políticas = 120 ejecuciones. Terminaron 114 y fallaron seis. Los resultados están en veinte ficheros results.csv, uno por RFP y modelo, con seis filas cada uno.
Las tres políticas:
dynamic: un agente diseña el equipo para cada pliego y después se ejecutan los perfiles que ha generado.fixed: un equipo predefinido y revisado, el mismo para todos los pliegos.frozen: un equipo diseñado una sola vez durante la calibración y reutilizado sin tocarlo.
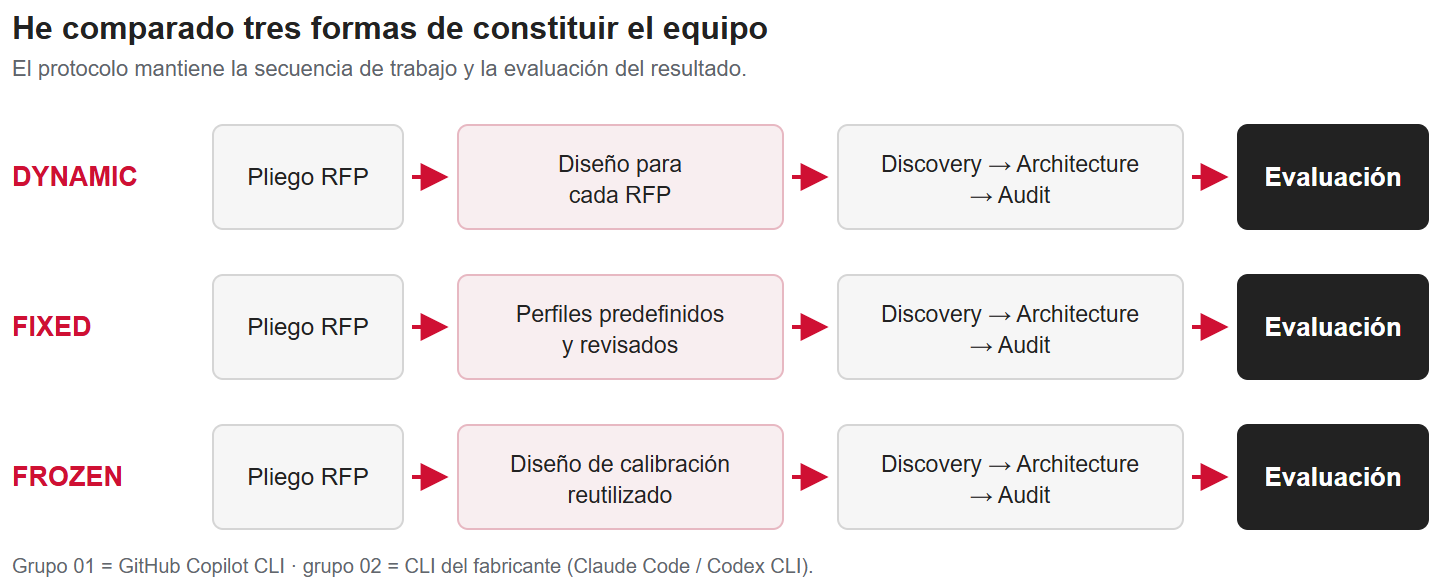
Diagrama 1 · Dónde cambia la composición del equipo en cada política. Es el protocolo, no un registro de las llamadas internas de cada CLI.
Cuando hablo de harness en este experimento me refiero a todo lo que rodea al modelo: el runner que encadena discovery → architecture → audit, los perfiles de agente, el contrato de salida, el gate y el corrector. Las tres políticas comparten ese harness; lo único que cambia es cómo se compone el equipo.
Dos cosas que no comparé, para que nadie lea más de lo que hay:
- El enrutamiento nativo de subagentes de cada CLI. Las etapas las controlaba mi runner. Lo que mido es qué pasa al mover el mismo pipeline de una CLI a otra, no todo lo que cada CLI sabe hacer.
- El efecto puro de especializar agentes.
dynamicañade una llamada de diseño, y sus perfiles no tienen la misma extensión que los defixed. Comparo políticas completas, con todo lo que cada una arrastra.
El instrumento lo he publicado en AgentsBenchmarkToolKit: runner, perfiles equivalentes para las tres CLI, generador de casos, corrector y pruebas offline. Ojo con un detalle: el repo no contiene los diez pliegos de este artículo (quiero que lo ejecutes tú, quiero que tú lo veas con tus propios ojos, por eso no he subido respuestas o logs). Trae un corpus de cien RFP en inglés, más un pliego de calibración.
Nota: Al tratarse de IA, logicamente no podrás reproducirlo exactamente igual que lo mio, por eso no he puesto los output, para que veas tú, tu propio resultado.
3. La trazabilidad
El grupo 01 lo ejecuté con GitHub Copilot CLI y el grupo 02 con la CLI de cada fabricante: Claude Code para Opus 5.5 y Codex CLI para Astra.
4. Cómo medí
Recall: de los defectos que sé que hay en el pliego, cuántos encuentra el informe según el corrector.
Recall = defectos detectados / defectos conocidos × 100
Con quince defectos sembrados, un informe que encuentra doce saca un 80 %; uno que encuentra nueve, un 60 %. Tres defectos de diferencia que, en un pliego real, son tres sorpresas en plena ejecución del contrato.
Pero el recall tiene trampa: se puede inflar señalando demasiadas cláusulas. Por eso separo cuatro preguntas que no son intercambiables:
| Indicador | Qué pregunta | En este artículo |
|---|---|---|
| Recall | ¿Qué proporción de los defectos sembrados encuentra? | Lo mido. |
| Precisión | ¿Cuántos de los problemas señalados son defectos de verdad? | Pendiente. |
| Completitud | ¿Cuántas ejecuciones terminan y entregan un informe evaluable? | Lo mido. |
| Gate | ¿Cumple la salida el contrato de estructura, referencias y formato? | Lo aplico; aprobarlo no garantiza cobertura. |
El recall lo agrego de dos formas. El condicional solo cuenta las ejecuciones que terminaron. El operacional pone un cero a la que no entregó informe. Si nueve ejecuciones terminan con un 80 % de media y la décima falla, el condicional es 80 % y el operacional 72 %. Ese cero no significa que el agente leyera el pliego y no encontrara nada: significa que no entregó. Para quien espera el informe, el resultado práctico es el mismo.
Dos límites que conviene tener delante. El corrector es heurístico y la revisión humana independiente está realizada por un colega (que trabaja en algo similar a lo mio, por tanto puede estar sesgado, no es un cliente real).
Un 76,7 % significa que, en promedio, el equipo encontró unos tres de cada cuatro defectos sembrados, según mi corrector. No significa que vaya a acertar el 76,7 % en el próximo proyecto.
5. Resultados: doce configuraciones
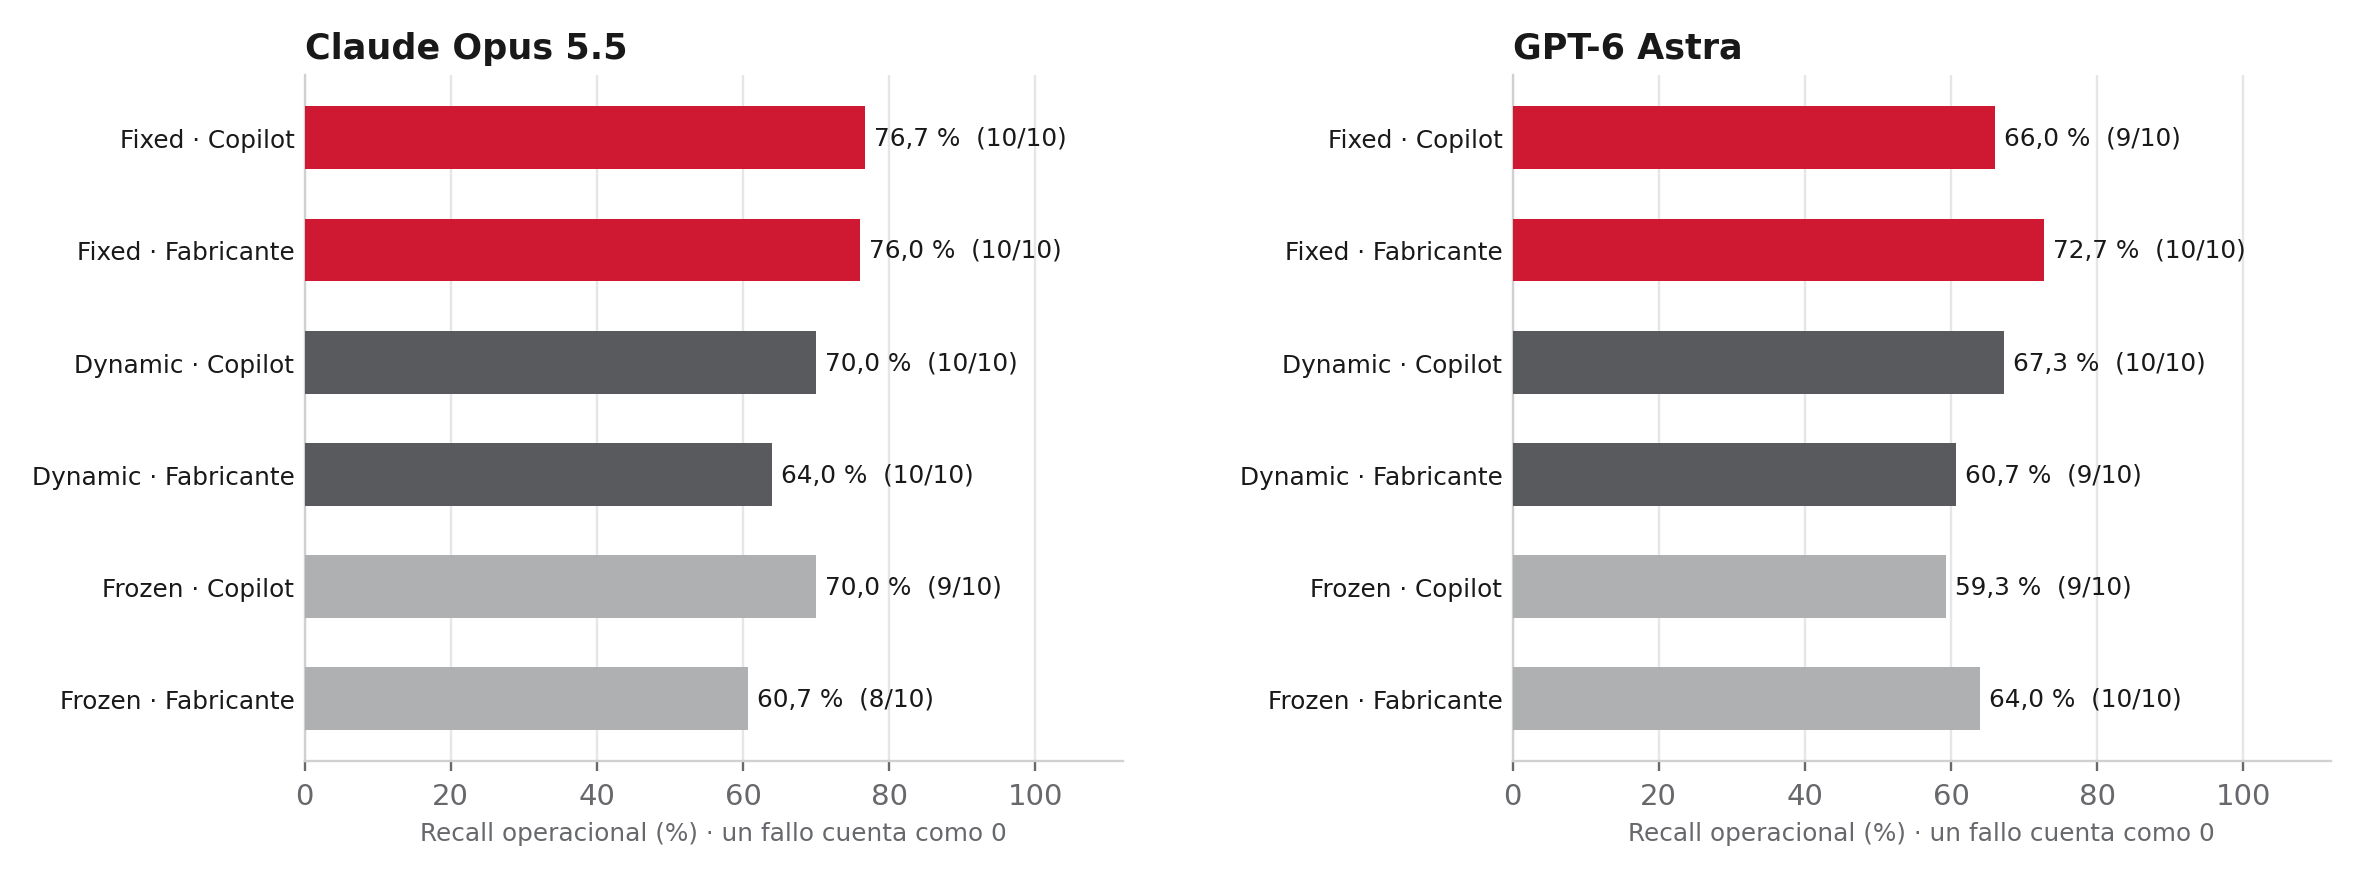
Figura 1 · Recall operacional de las doce configuraciones (un fallo cuenta como 0). «Fabricante» es Claude Code para Claude y Codex CLI para Astra
| Modelo / entorno | Política | Recall condicional | Completadas | Recall operacional |
|---|---|---|---|---|
| Claude / Claude Code | dynamic | 64,0 % | 10/10 | 64,0 % |
| Claude / Copilot | dynamic | 70,0 % | 10/10 | 70,0 % |
| Claude / Claude Code | fixed | 76,0 % | 10/10 | 76,0 % |
| Claude / Copilot | fixed | 76,7 % | 10/10 | 76,7 % |
| Claude / Claude Code | frozen | 75,8 % | 8/10 | 60,7 % |
| Claude / Copilot | frozen | 77,8 % | 9/10 | 70,0 % |
| Astra / Copilot | dynamic | 67,3 % | 10/10 | 67,3 % |
| Astra / Codex | dynamic | 67,4 % | 9/10 | 60,7 % |
| Astra / Copilot | fixed | 73,3 % | 9/10 | 66,0 % |
| Astra / Codex | fixed | 72,7 % | 10/10 | 72,7 % |
| Astra / Copilot | frozen | 65,9 % | 9/10 | 59,3 % |
| Astra / Codex | frozen | 64,0 % | 10/10 | 64,0 % |
Con Claude y fixed, empate: 76,7 % y 76,0 %, diez de diez en ambos casos. Un defecto de diferencia en 150 oportunidades.
frozen con Claude + Copilot saca el mejor recall condicional de toda la tabla, 77,8 %, pero falla una ejecución y el operacional baja a 70,0 %. Si solo enseñara la cifra de las ejecuciones que terminaron, estaría escondiendo justo la parte del resultado que más le importa a quien espera el informe.
Con Astra pasa algo parecido. Copilot + fixed llega al 73,3 % en las nueve ejecuciones que terminó; Codex + fixed se queda en 72,7 %, pero completa las diez. En operacional: 66,0 % frente a 72,7 %. Con Astra, en esta muestra, la opción operativa más sólida es Codex CLI + fixed.
Y la excepción, que también es resultado: con Astra + Copilot, dynamic (67,3 %) supera a fixed (66,0 %). fixed gana en tres de los cuatro pares, no en los cuatro.
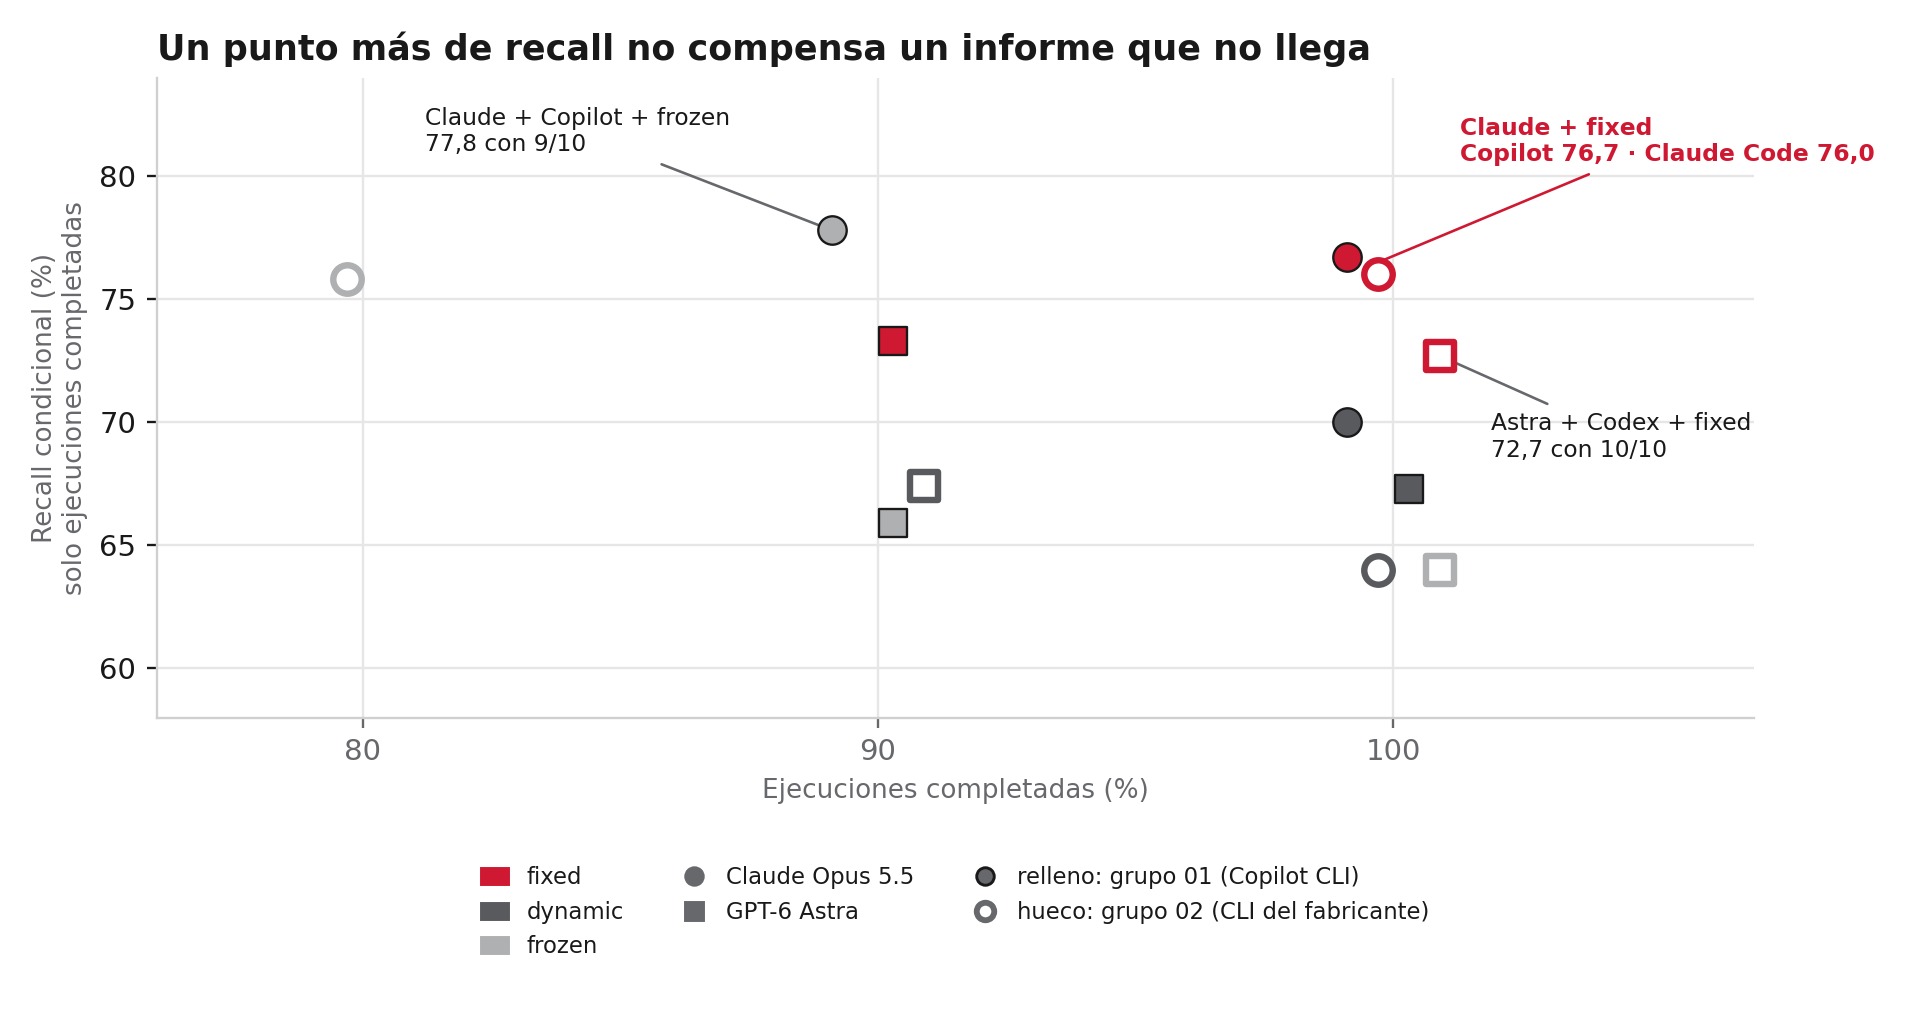
Figura 2 · Recall condicional frente a ejecuciones completadas. Los puntos están desplazados en horizontal para que no se solapen. Completar una ejecución no es lo mismo que repetir los mismos hallazgos.
6. ¿Cuál es mejor, de verdad?
Aquí separo decidir de demostrar.
Decidir es fácil: si mañana tengo que auditar un pliego, uso Claude Opus 5.5 con un equipo fixed. Es la combinación con mejor recall operacional y completó todas sus ejecuciones en las dos CLI.
Demostrar que una CLI es mejor que otra, no puedo. Comparé los dos grupos de Claude + fixed sobre las mismas diez RFP: la diferencia media es de 0,67 puntos a favor del grupo 01. Un bootstrap pareado por RFP —40.000 remuestreos con semilla fija— da un intervalo percentil aproximado del 95 % que va de −2,7 a +5,3 puntos. El intervalo cruza el cero con holgura. Tampoco hice una prueba de equivalencia con un margen fijado de antemano, así que tampoco puedo decir que sean equivalentes: solo que, con estos datos, no se distinguen.
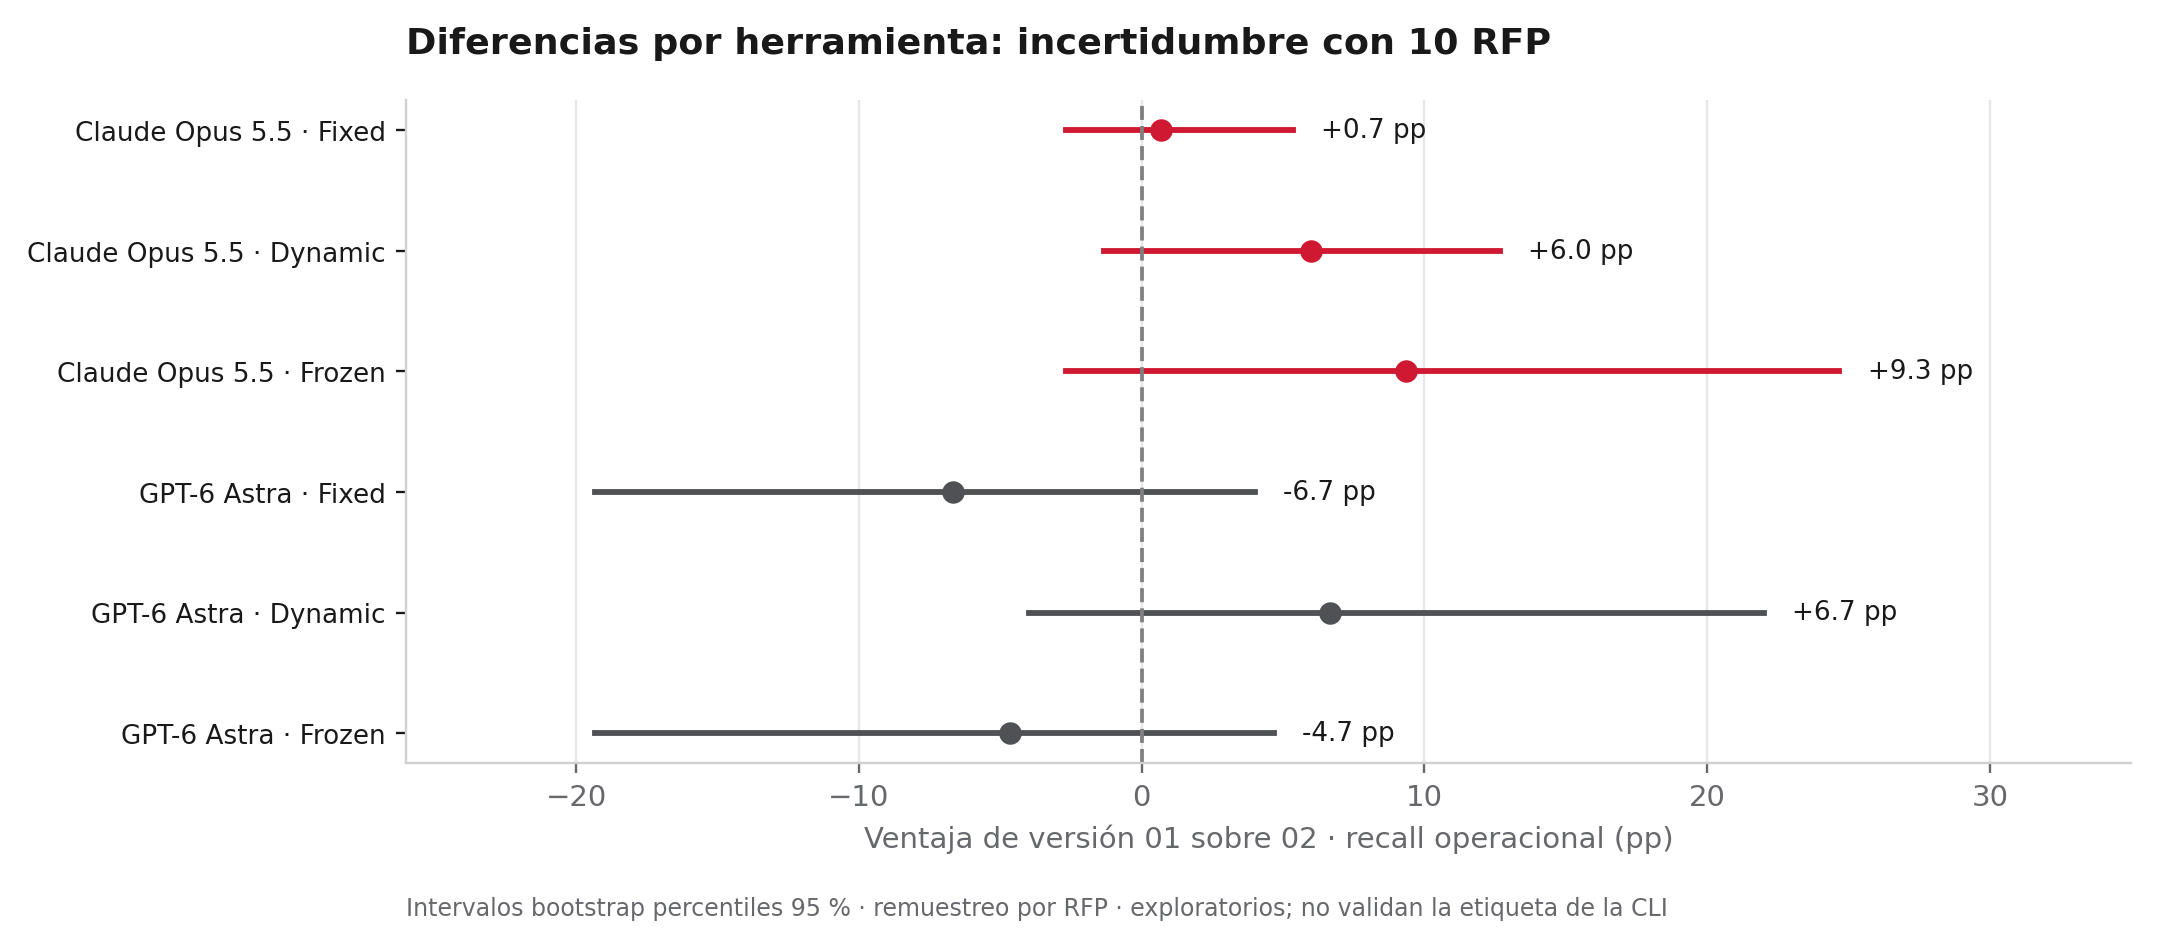
Figura 3 · Diferencia de recall operacional entre grupos (01 − 02) con intervalos bootstrap exploratorios por RFP.
La unidad de remuestreo es el pliego. Los quince defectos de un pliego comparten contexto y no son observaciones independientes, y las 120 ejecuciones tampoco son 120 proyectos distintos.
Hay una pista que no quiero esconder: con Claude, el grupo 01 va por delante en las tres políticas (+0,7, +6,0 y +9,3 puntos); con Astra, el signo cambia según la política.
Y lo que no sé: si mañana, con el mismo pliego y la misma configuración, el equipo encontraría lo mismo. No repetí combinaciones sobre el mismo pliego, así que de estabilidad no hablo. Para eso hay que repetir casos y compararlos.
Lo que estos datos permiten decir: fixed da aquí el mejor equilibrio entre cobertura y completitud; con Claude, las dos CLI no se distinguen; con Astra, Codex + fixed fue la opción operativa más sólida de la muestra. Lo que no permiten: afirmar que una CLI, un modelo o una política sean mejores en cualquier dominio, decir nada sobre estabilidad ni atribuir los seis fallos a una política, porque todavía no he analizado sus causas.
7. ¿Por qué diez y no cien?
Mi plan era llegar a cien pliegos por combinación. Paré en diez, y debo contar el porqué.
Con diez ya tenía respuesta a la pregunta de ingeniería que me había hecho: fixed iba primero en tres de cuatro pares, los fallos de ejecución cambiaban el orden y la diferencia entre las dos CLI con Claude era demasiado pequeña para coronar a nadie. Y seguir costaba: estas diez se llevaron 200 USD en créditos para GitHub, 100 USD para Claude y 120 USD para ChatGPT. Cien habrían costado del orden de diez veces eso.
Sobre esas 40 horas: son la suma de las duraciones de cada invocación, medidas con reloj de pared. No son horas de cómputo activo ni horas de calendario.
La crítica más justa que se le puede hacer a este experimento es esta: no fijé una regla de parada antes de empezar. Paré mirando resultados. Por eso el protocolo del toolkit obliga a fijar la regla de parada, el número de casos y el análisis antes de ejecutar nada. La lección la aprendí aquí; en el repo la he dejado escrita.
Para ver cuánto dependía la elección de un pliego concreto, quité las RFP de una en una y volví a calcular la mejor configuración. En ocho de las diez exclusiones siguió primera Claude + Copilot CLI + fixed. Al quitar la RFP 2 pasó delante Claude + Copilot CLI + frozen; al quitar la RFP 7, Claude + Claude Code + fixed.
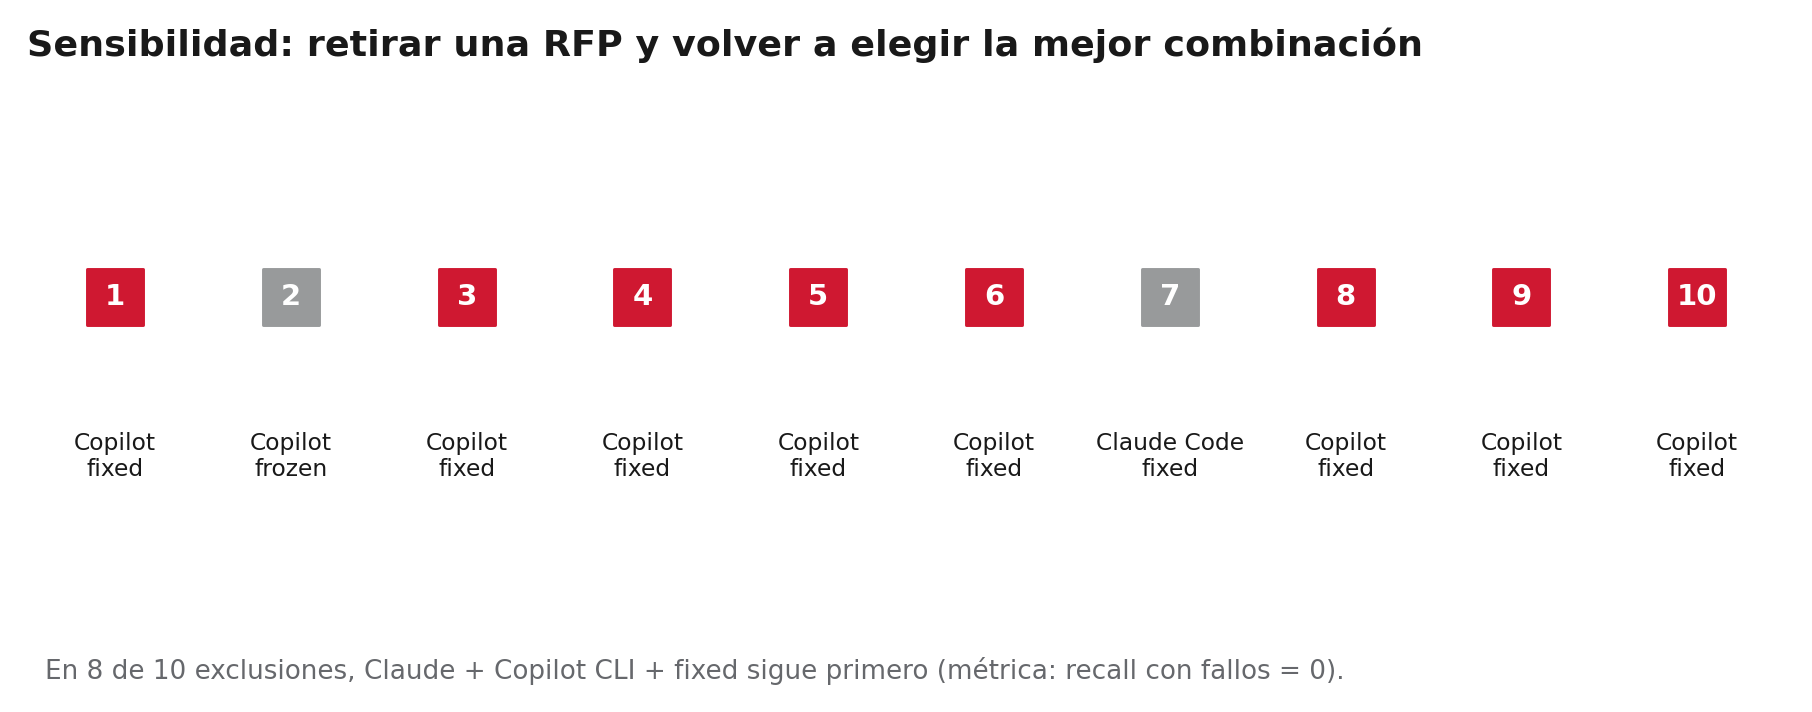
Figura 4 · Leave-one-RFP-out: mejor configuración al excluir cada pliego. Reutiliza los mismos datos, así que mide sensibilidad; no es una validación independiente.
Los números del 1 al 10 son identificadores de pliego, no el orden en que los ejecuté: esto no es una curva de convergencia. Y que el ranking aguante ocho de diez exclusiones no prueba que con cien pliegos saliera el mismo orden. Más casos estrecharían los intervalos y podrían cambiar el orden entre configuraciones tan próximas. Acepto esa incertidumbre para decidir; no la doy por resuelta.
8. QA no es QC
En el experimento anterior vi que tanto el gate como el corrector podían equivocarse. Por eso separo las reglas del proceso de la evaluación del resultado.
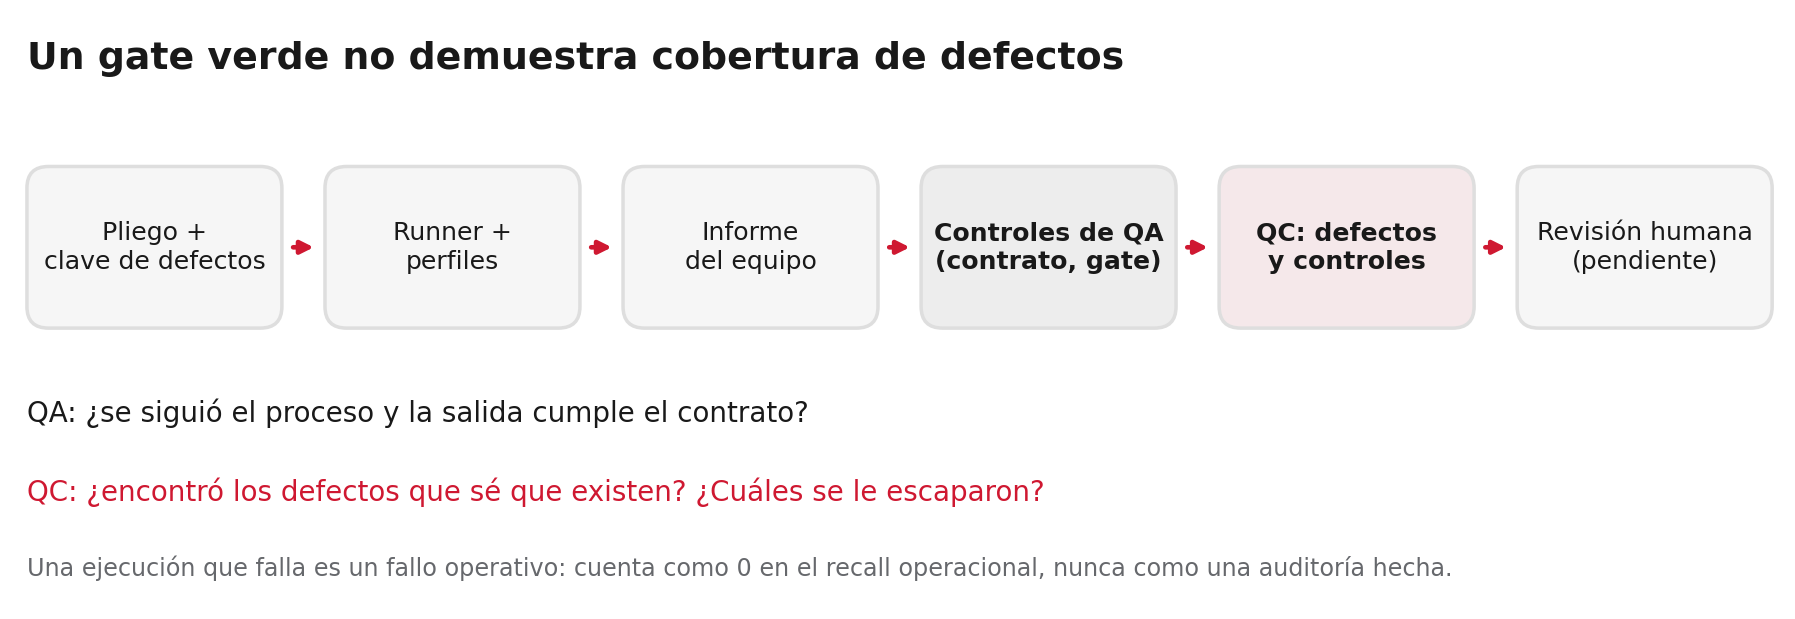
Diagrama 2 · Los controles de QA verifican el proceso y el contrato; el QC contrasta el resultado con defectos conocidos; la revisión humana valida el sistema de medida. En esta campaña, la revisión humana sigue pendiente.
QA (aseguramiento de la calidad) son los criterios, las políticas, la trazabilidad y los controles del proceso. QC (control de la calidad) es comprobar el producto: qué riesgos encontró y cuáles se le escaparon. El gate es uno de mis controles de QA, no todo el QA. Y un corrector heurístico, por sí solo, tampoco es un QC completo.
Lo he visto en la práctica: un informe puede cumplir el contrato de formato a la perfección y omitir riesgos críticos. Y yo puedo definir bien un criterio de detección y puntuarlo mal. Así que tengo que evaluar los informes y, además, evaluar el instrumento con el que los evalúo.
Esto no significa que el gobierno tenga que vivir fuera de la CLI. Claude Code permite definir subagentes reutilizables, permisos, hooks, skills y memoria persistente, y el resto de CLI va en la misma dirección. Puedo usar todo eso para implementar partes de mi metodología. Lo que la herramienta no trae es la metodología: los requisitos, las decisiones, las pruebas y los criterios con los que acepto o rechazo un trabajo. Eso lo pongo yo.
Mi frontera de confianza no está en que el modelo «se acuerde» de qué agentes creó en una ejecución. Está en especificaciones verificables, decisiones registradas, evidencias de pruebas y criterios de aceptación que otro equipo pueda entender y aplicar. Y mi propio harness no se libra: tiene que pasar la misma exigencia.
9. Conclusión: fixed gana aquí; el método no viene con el modelo
Lo que sí puedo sostener después de estas diez RFP: en este experimento, un equipo predefinido, revisado y reutilizable dio mejores resultados operativos que improvisar su composición para cada pliego. No en todos los pares —hay una excepción y la he enseñado—, pero sí en tres de cuatro y en la mejor configuración observada. Un equipo fijo no es un equipo rígido: es un equipo del que conozco los roles, los criterios y la forma de evaluarlo.
Mi elección es Claude Opus 5.5 con fixed. ¿Y la CLI? Con estos datos, empate. Si hoy tengo que poner una en la foto pongo Copilot CLI, porque sacó la cifra más alta, completó las diez y con Claude va por delante en las tres políticas. Pero que nadie lo lea como «Copilot es mejor que Claude Code».
Eso sí dice algo interesante de las CLI. El fabricante de un modelo puede tener, en un momento dado, ventajas de integración y de conocimiento de su propio modelo. Pero en esta muestra, con Claude, una CLI que no es del fabricante estuvo a su altura. Es una ventaja táctica, y las ventajas tácticas se acortan deprisa.
La cuestión que me preocupa es otra. El harness que trae una CLI resuelve muy bien cómo invocar el modelo, usar herramientas, delegar y gestionar el contexto de una ejecución. Lo que no he visto demostrado —de forma verificable y reproducible— es que esas herramientas, por sí solas, diseñen y sostengan una metodología completa para un SDLC de extremo a extremo: requisitos y decisiones trazables, arquitectura, pruebas, equivalencia funcional cuando toca, revisión, seguridad, despliegue y transferencia de conocimiento. Este benchmark mide auditorías de RFP; no demuestra nada sobre el SDLC entero. Lo que acabo de decir es juicio profesional, y lo marco como tal.
En mi caso, esa metodología existe y la estoy usando. No esta en el repositorio adjunto, solo he puesto ciertos agentes que podrían hacer algo similar, no es ni el 1% y para ti quizá no sean ni siquiera aceptables tal y como estan definidos.
Aquí conecto con el Software Craftsmanship. Me reconozco en lo que pide su manifiesto: software bien construido, valor que se añade de forma continua, una comunidad de profesionales y relaciones productivas con los clientes. Ahora que puedo generar código y delegar tareas mucho más deprisa, esos compromisos pesan más, no menos.
Yo he construido la herramienta, he ejecutado las pruebas y he tomado las decisiones. También me toca explicar sus límites, revisar lo que no he verificado y corregir lo que los datos cuestionen. Por eso he publicado el toolkit: para que otros puedan inspeccionarlo y hacerse sus propias preguntas.
¿Qué haría en la siguiente versión del toolkit?
- Registrar la versión de la CLI y el modelo devuelto en cada invocación (con versiones, aquí no puse la versión exacta), no por lote, y fechar cada ejecución.
- Repetir cada configuración varias veces sobre el mismo pliego para poder hablar de estabilidad. Nos permitiría tener una media recortada, creo que 5 ejecuciones quitando el máximo y el mínimo, sería un valor aceptable.
- Consolidar controles y señuelos para medir falsas alarmas, no solo cobertura.
- Pasar una muestra a revisión humana ciega por dos revisores independientes y que no estén sesgados (como mi colega).
- Fijar antes de ejecutar la regla de parada, el número de casos y el análisis.
- Ejecutar el corpus de cien RFP y publicar los resultados en un paquete separado del código.
El modelo se alquila. El criterio con el que decido si un resultado es bueno, no. Puedo delegar tareas en una IA; la responsabilidad de entregar buen software sigue siendo mía.