
Introducción. Volver al oficio
Hacía tiempo que no escribía un artículo tan centrado en aquello que siempre me ha interesado del movimiento Software Craftsmanship: el oficio de construir software, las buenas prácticas, los patrones y, sobre todo, la responsabilidad que asumimos cuando nuestros sistemas llegan a producción.
Últimamente he dedicado bastante tiempo a la inteligencia artificial, los agentes, la gobernanza y la transformación del desarrollo. Son asuntos relevantes, pero hay algo que no cambia: seguimos siendo responsables del software que ponemos en manos de otros, incluso cuando una IA ha escrito parte de ese código.
El Manifiesto por el Software Craftsmanship nos invita a ir más allá del software que simplemente funciona y aspirar al software bien construido. Esa diferencia es todavía más importante cuando hablamos de sistemas distribuidos y modernización de aplicaciones heredadas.
Construir software no consiste únicamente en picar código ni en coger patrones de aquí y de allá para montar una especie de LEGO arquitectónico. En ese LEGO también hay piezas que no siempre se ven en las diapositivas: seguridad, identidad, contratos, datos, pruebas, recuperación, operación, costes, licencias, equipos, decisiones arquitectónicas, procedencia del software y una salida cuando una dependencia falla o desaparece.
Un hospital, una administración pública, un banco, una industria o una plataforma logística pueden tener problemas similares: operaciones que no se pueden perder, procesos que duran horas, consumidores que se caen y sistemas heredados que aún mantienen la verdad de negocio. No es una cuestión sectorial. Es ingeniería.
No quiero diseñar alrededor de un catálogo de patrones. Quiero hacer lo contrario: partir de un problema real, comparar alternativas y justificar la decisión con garantías verificables. Es una idea que desarrollé en mi monográfico sobre Registros de Decisiones Arquitectónicas (ADR).
Lo que viene no es un catálogo de patrones. Es una lista de innegociables.
Cuando me siento delante de un sistema heredado que sostiene operaciones que no se pueden perder, hay un conjunto de cosas que no negocio. No porque queden bien en un diagrama, sino porque sin ellas no puedo responder a la única pregunta que importa el día que algo falla: qué se confirmó, qué está pendiente y qué podemos recuperar sin provocar un daño nuevo.
Los primeros innegociables de esa lista se apoyan en cuatro invariantes de diseño:
- Un único propietario de escritura por agregado. Uno, no dos conviviendo «temporalmente».
- Un límite transaccional explícito: saber qué commit protege qué efecto.
- Idempotencia en destino con identificador de evento estable, no la deduplicación del broker como única defensa.
- Recuperación determinista: cada proceso sabe desde qué hito persistente continúa.
- Reintentos clasificados por causa. Un timeout y un contrato roto no se tratan igual.
- Reconciliación para todo ACK ambiguo y para todo efecto irreversible.
- RTO y RPO por proceso, medidos inyectando fallos, no deducidos de un SLA.
- Inventario y procedencia de lo que ejecutamos: dependencias, licencias, SBOM y digest.
- Un ADR por cada decisión transversal, con alternativas y reversibilidad.
- Una salida: cómo sustituyo un componente si cambia su licencia, su mantenedor o su rumbo.
Los seis primeros hablan del sistema que escribimos nosotros. Los cuatro últimos, del software que no escribimos y del que seguimos siendo responsables. Por eso el artículo tiene dos mitades y las recorro en ese orden: de la sección 1 a la 6, cómo se comporta nuestro sistema cuando falla; de la 7 en adelante, cómo demostramos qué estamos ejecutando realmente.
Y si solo te llevas una idea, que sea esta: cada punto de esa lista hay que demostrarlo, no declararlo.
1. Resiliencia no significa que el contenedor vuelva a arrancar
Imaginemos una operación confirmada en un sistema transaccional. La aplicación guarda el estado, pero el servicio que debe procesar la siguiente etapa está caído. Media hora más tarde vuelve a estar disponible. ¿Qué hacemos?
La respuesta no puede ser «reiniciamos el pod». Debemos conocer exactamente qué se confirmó, qué se publicó, qué aceptó el destino, qué está pendiente, qué se puede repetir y qué requiere intervención. Son preguntas distintas; mezclarlas produce estados ambiguos.
Por eso fijaría cuatro invariantes de diseño:
- Durabilidad: dentro del escenario de fallo definido, una operación confirmada conserva su estado y su obligación de integración.
- Idempotencia: una entrega duplicada no debe duplicar el efecto de negocio.
- Recuperación determinista: cada proceso sabe desde qué hito persistente puede continuar.
- Continuidad: una dependencia caída no detiene indiscriminadamente procesos que pueden continuar de forma segura.
El quinto invariante es de naturaleza organizativa: debemos poder demostrar los cuatro anteriores, no darlos por hechos porque un servicio administrado los mencione en su documentación.
2. Strangler Fig: retirar responsabilidades, no solo cambiar rutas
El patrón Strangler Fig sigue siendo uno de los mejores puntos de partida para una modernización brownfield. Nos permite sustituir capacidades gradualmente, manteniendo el sistema original durante la transición. Pero un reverse proxy no moderniza un dominio por sí solo.
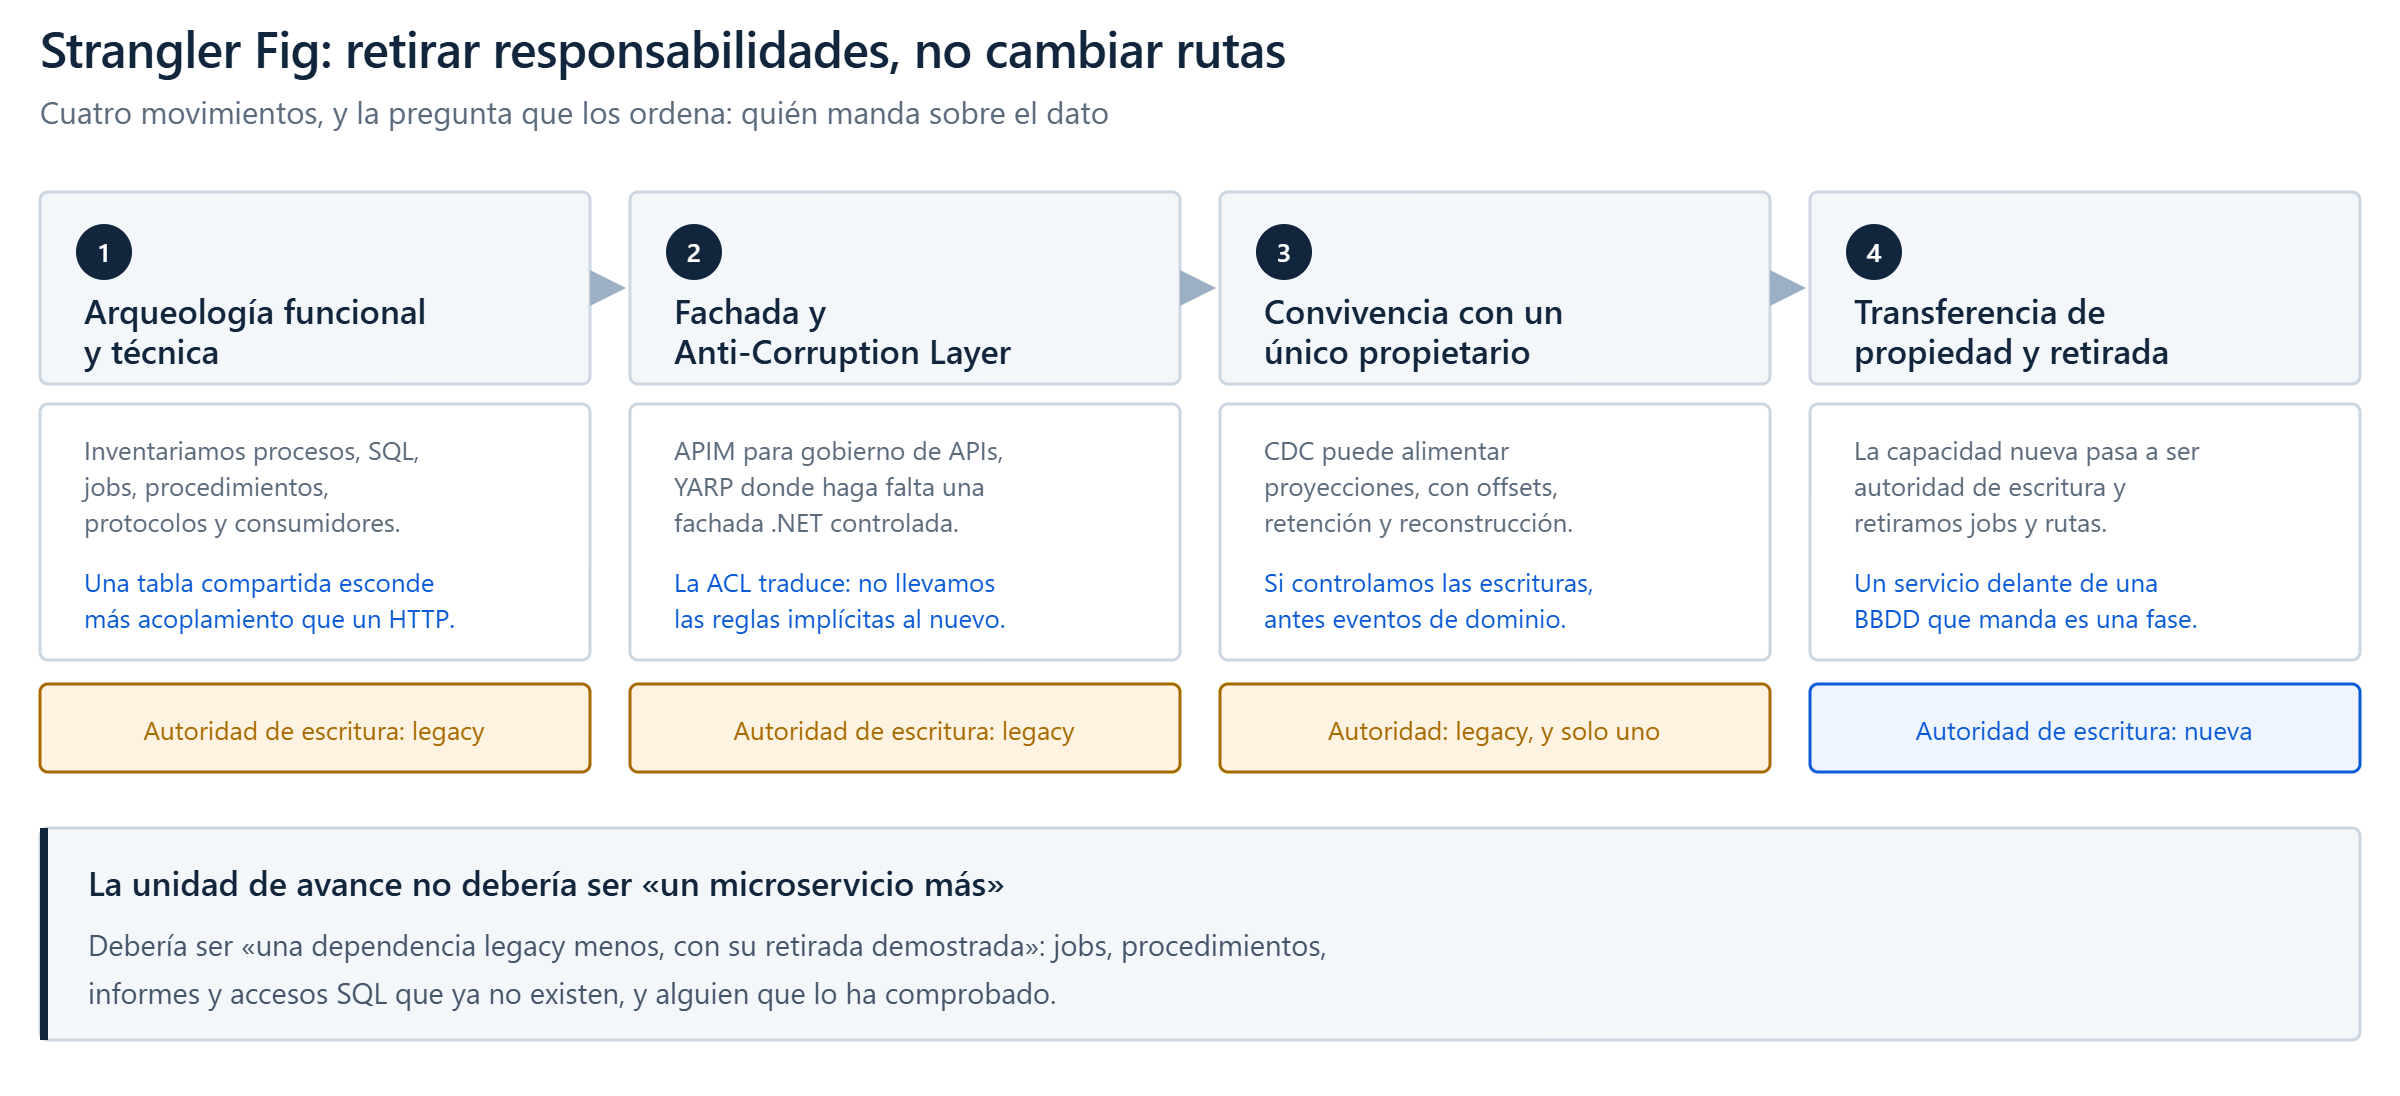
Primero, arqueología funcional y técnica. Inventariamos procesos, SQL, procedimientos almacenados, accesos no declarados, jobs, ficheros, protocolos y consumidores. Una tabla compartida suele esconder más acoplamiento que una llamada HTTP.
Después, fachada y Anti-Corruption Layer. Usaría Azure API Management para gobierno de APIs y YARP donde necesitemos una fachada .NET controlada. La Anti-Corruption Layer traduce la semántica del sistema original; evita llevar a la nueva solución las mismas tablas, códigos y reglas implícitas del monolito.
Durante la convivencia, un único propietario de escritura por agregado. Cuando todavía escriben aplicaciones heredadas, CDC puede alimentar proyecciones o integraciones. Pero debe contar con offsets persistidos, retención suficiente, reconstrucción y reconciliación. Si controlamos todas las escrituras de una nueva capacidad, preferiría eventos de dominio y Outbox antes que convertir sus tablas nuevas en otro origen CDC por inercia.
Finalmente, transferencia de propiedad y retirada. La capacidad nueva pasa a ser autoridad de escritura, sus consumidores dejan de depender de las tablas antiguas y podemos retirar jobs, procedimientos y rutas heredadas. Un servicio nuevo delante de una BBDD legacy que sigue mandando no es el destino: es una fase transitoria.
La unidad de avance no debería ser «un microservicio más». Debería ser «una dependencia legacy menos, con su retirada demostrada».
3. Un catálogo de patrones, pero con criterio de selección
| Patrón | Lo usaría cuando… | Lo que realmente garantiza / limita |
|---|---|---|
| Strangler Fig + ACL | Hay que sustituir capacidades sin un big bang. | Permite aislar semántica y migrar la propiedad gradualmente; no elimina por sí solo la BBDD compartida. |
| Transactional Outbox | Un commit de negocio obliga a emitir un evento. | Registra ambos en una transacción local; la entrega puede repetirse. |
| Transactional Inbox | Un consumidor puede recibir el mismo evento más de una vez. | Permite efectos locales idempotentes si el registro Inbox y el efecto comparten transacción. |
| CDC | Las escrituras siguen ocurriendo fuera de nuestro servicio. | Observa cambios del origen; necesita gestionar lag, logs y snapshots. |
| Queue-Based Load Leveling | Productores y consumidores tienen velocidades distintas. | Absorbe picos mientras exista capacidad y retención suficientes. |
| Retry + jitter + circuit breaker | Los fallos son transitorios. | Evita tormentas de reintentos; no arregla errores funcionales permanentes. |
| Bulkhead | Una función secundaria puede monopolizar recursos. | Aísla capacidad, colas, hilos y presupuestos de fallo. |
| Saga / Durable Workflow | El proceso cruza servicios y dura minutos u horas. | Recuerda hitos y reanuda; una acción irreversible no siempre se compensa. |
| Stateful Actors | Necesitamos secuenciar operaciones por identidad de agregado. | Reduce conflictos locales; no da transacciones distribuidas ni entrega garantizada. |
| Reconciliation | Hay ACK ambiguos o divergencias entre sistemas. | Compara verdad de origen y efecto de destino; exige identificadores estables. |
No sumaría todos estos patrones en la misma solución. El criterio correcto es qué fallo concreto resuelve cada uno, qué nueva complejidad introduce y cómo lo probaríamos.
4. Mi arquitectura de referencia para capacidades nuevas
Cuando el servicio moderno controla el estado de negocio, empezaría con .NET + SQL transaccional + Outbox + broker duradero + Inbox + reconciliación. Añadiría orquestación o actores únicamente si el dominio lo necesita.
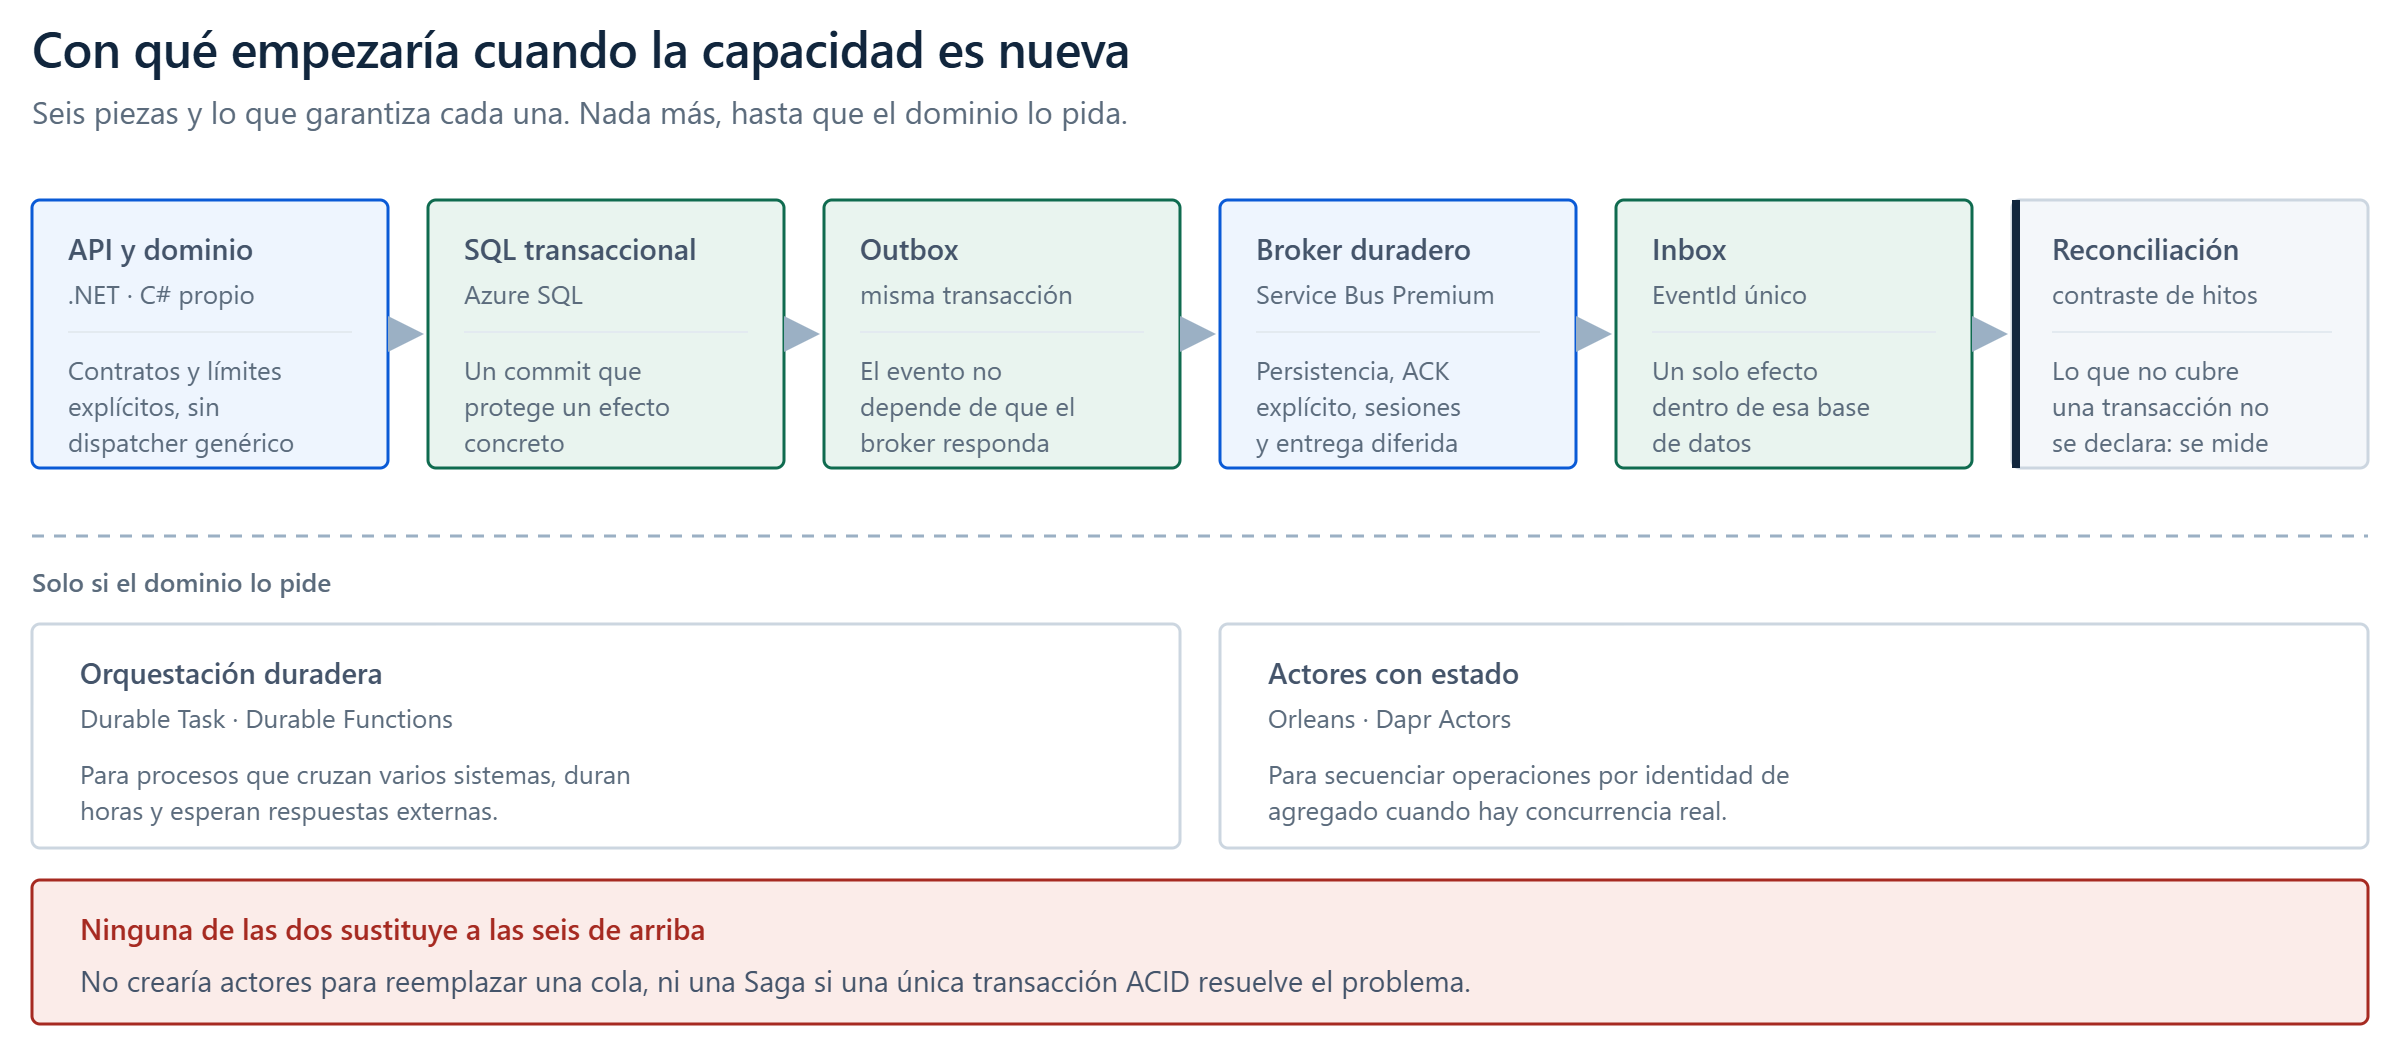
¿Por qué Azure Service Bus Premium? Para procesos empresariales de comandos, solicitudes e integraciones, me ofrece queues, topics, suscripciones, ACK explícito, sesiones y entrega diferida. Kafka o Event Hubs tienen sentido cuando de verdad necesitamos streaming, alto caudal, retención/replay y consumidores con offsets propios. No porque haya que «meter Kafka» cada vez que vemos CDC.
El productor: commit de negocio y evento, juntos
Este fragmento muestra la idea transaccional. Omite deliberadamente políticas de reintento, esquema completo y validaciones para que se vea el límite ACID:
// Esqueleto conceptual: una transacción, dos cambios persistidos.
await using var tx = await db.Database.BeginTransactionAsync(ct);

var request = BusinessRequest.Create(command.RequestId, command.Data);
db.Requests.Add(request);

db.OutboxMessages.Add(new OutboxMessage
{
    EventId = Guid.NewGuid(),
    AggregateId = request.Id,
    Type = "BusinessRequestCreated.v1",
    Payload = JsonSerializer.Serialize(new { request.Id }),
    CreatedAtUtc = timeProvider.GetUtcNow()
});

await db.SaveChangesAsync(ct);
await tx.CommitAsync(ct);
// La publicación al broker NO forma parte de esta transacción.
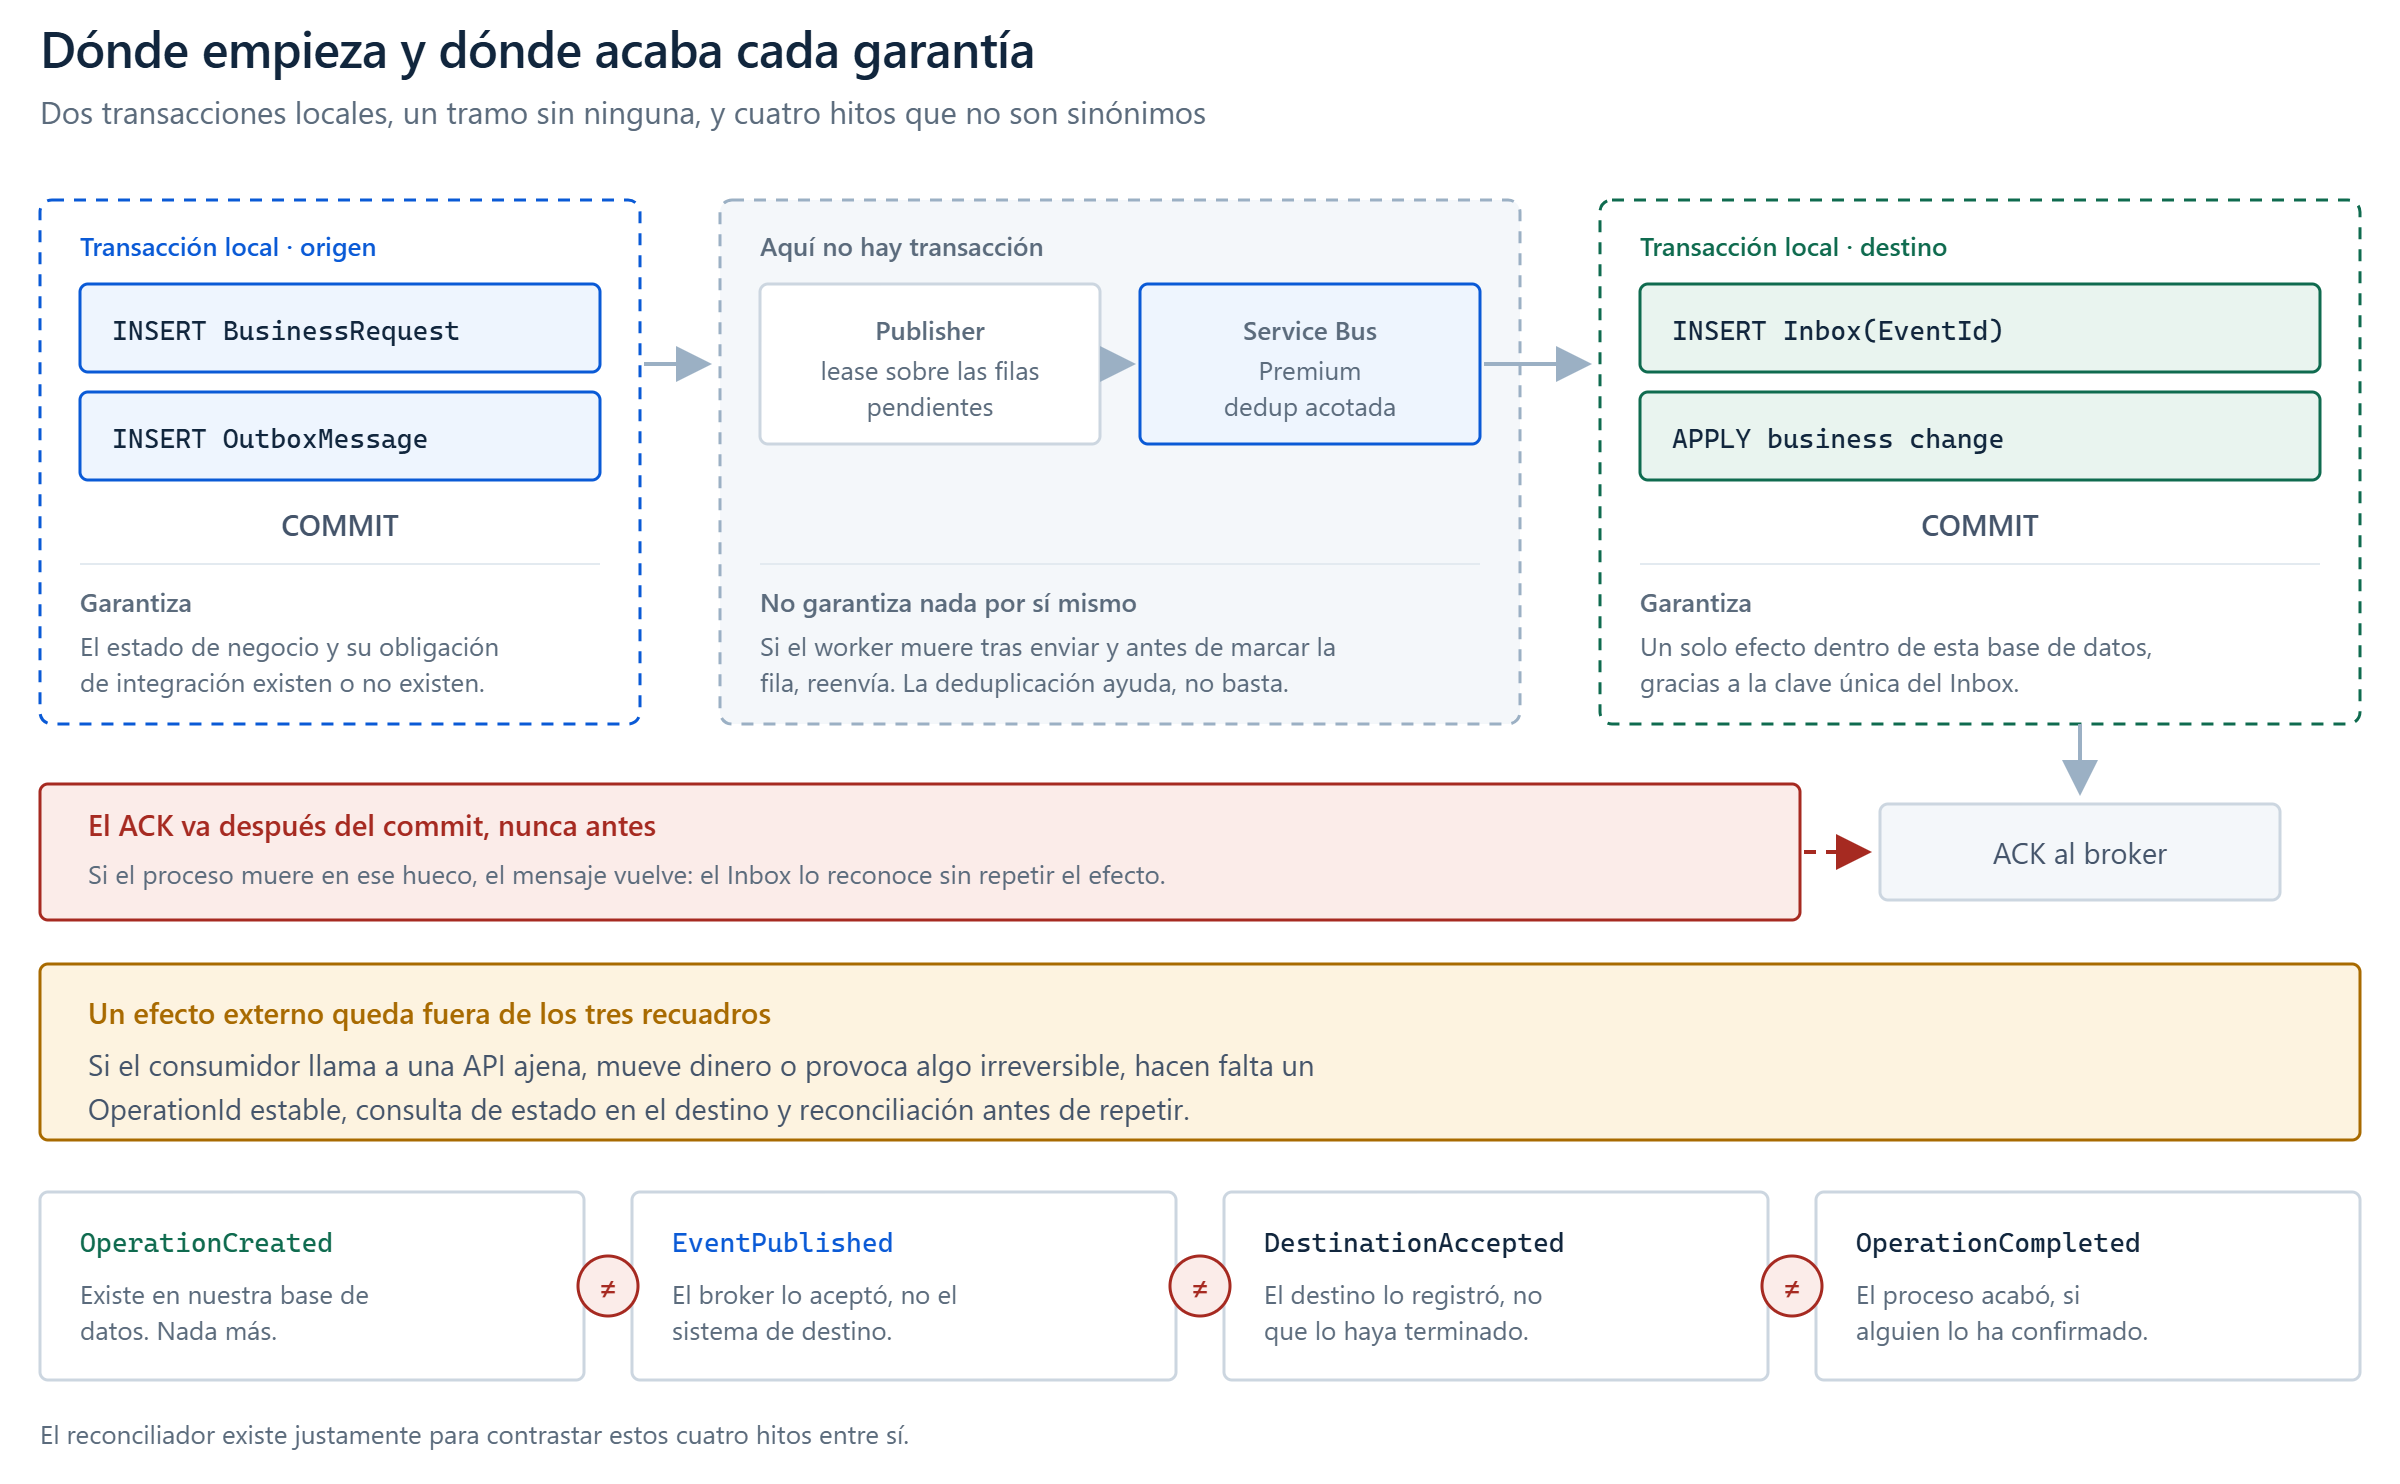
El publisher lee las filas pendientes, publica y registra el resultado. Si el envío se confirma pero el worker muere antes de marcar la fila como publicada, volverá a enviarla. Eso es esperado: necesitamos idempotencia en destino, un identificador de evento estable y un mecanismo de reclamación/lease para varios workers concurrentes. La deduplicación limitada del broker es un complemento, no nuestra única defensa.
El consumidor: reconocer solo después del efecto
RECEIVE event(EventId)
BEGIN local transaction
  IF Inbox contains EventId:
      COMMIT / ACK                   // ya se aplicó
  ELSE:
      INSERT Inbox(EventId)          // clave única
      APPLY business change
      COMMIT
      ACK                             // solo después del commit
Esto protege el efecto dentro de esa misma base de datos. Si el consumidor invoca una API externa, envia dinero o provoca un efecto irreversible, hacen falta OperationId, consulta de estado del destino y reconciliación. Ningún framework de mensajería regala exactamente-una-vez en todos los sistemas.
Dead Letters: minimizar los errores evitables, no ocultar las excepciones
Distinguiría un timeout de red de un evento incompatible, una referencia inexistente o una operación que exige aprobación humana. Reintentos limitados con backoff sirven para lo primero; cuarentena y resolución explícita para lo segundo. Las DLQ no son una papelera ni una métrica de éxito. Una DLQ vacía puede convivir con miles de procesos pendientes sin resolver.
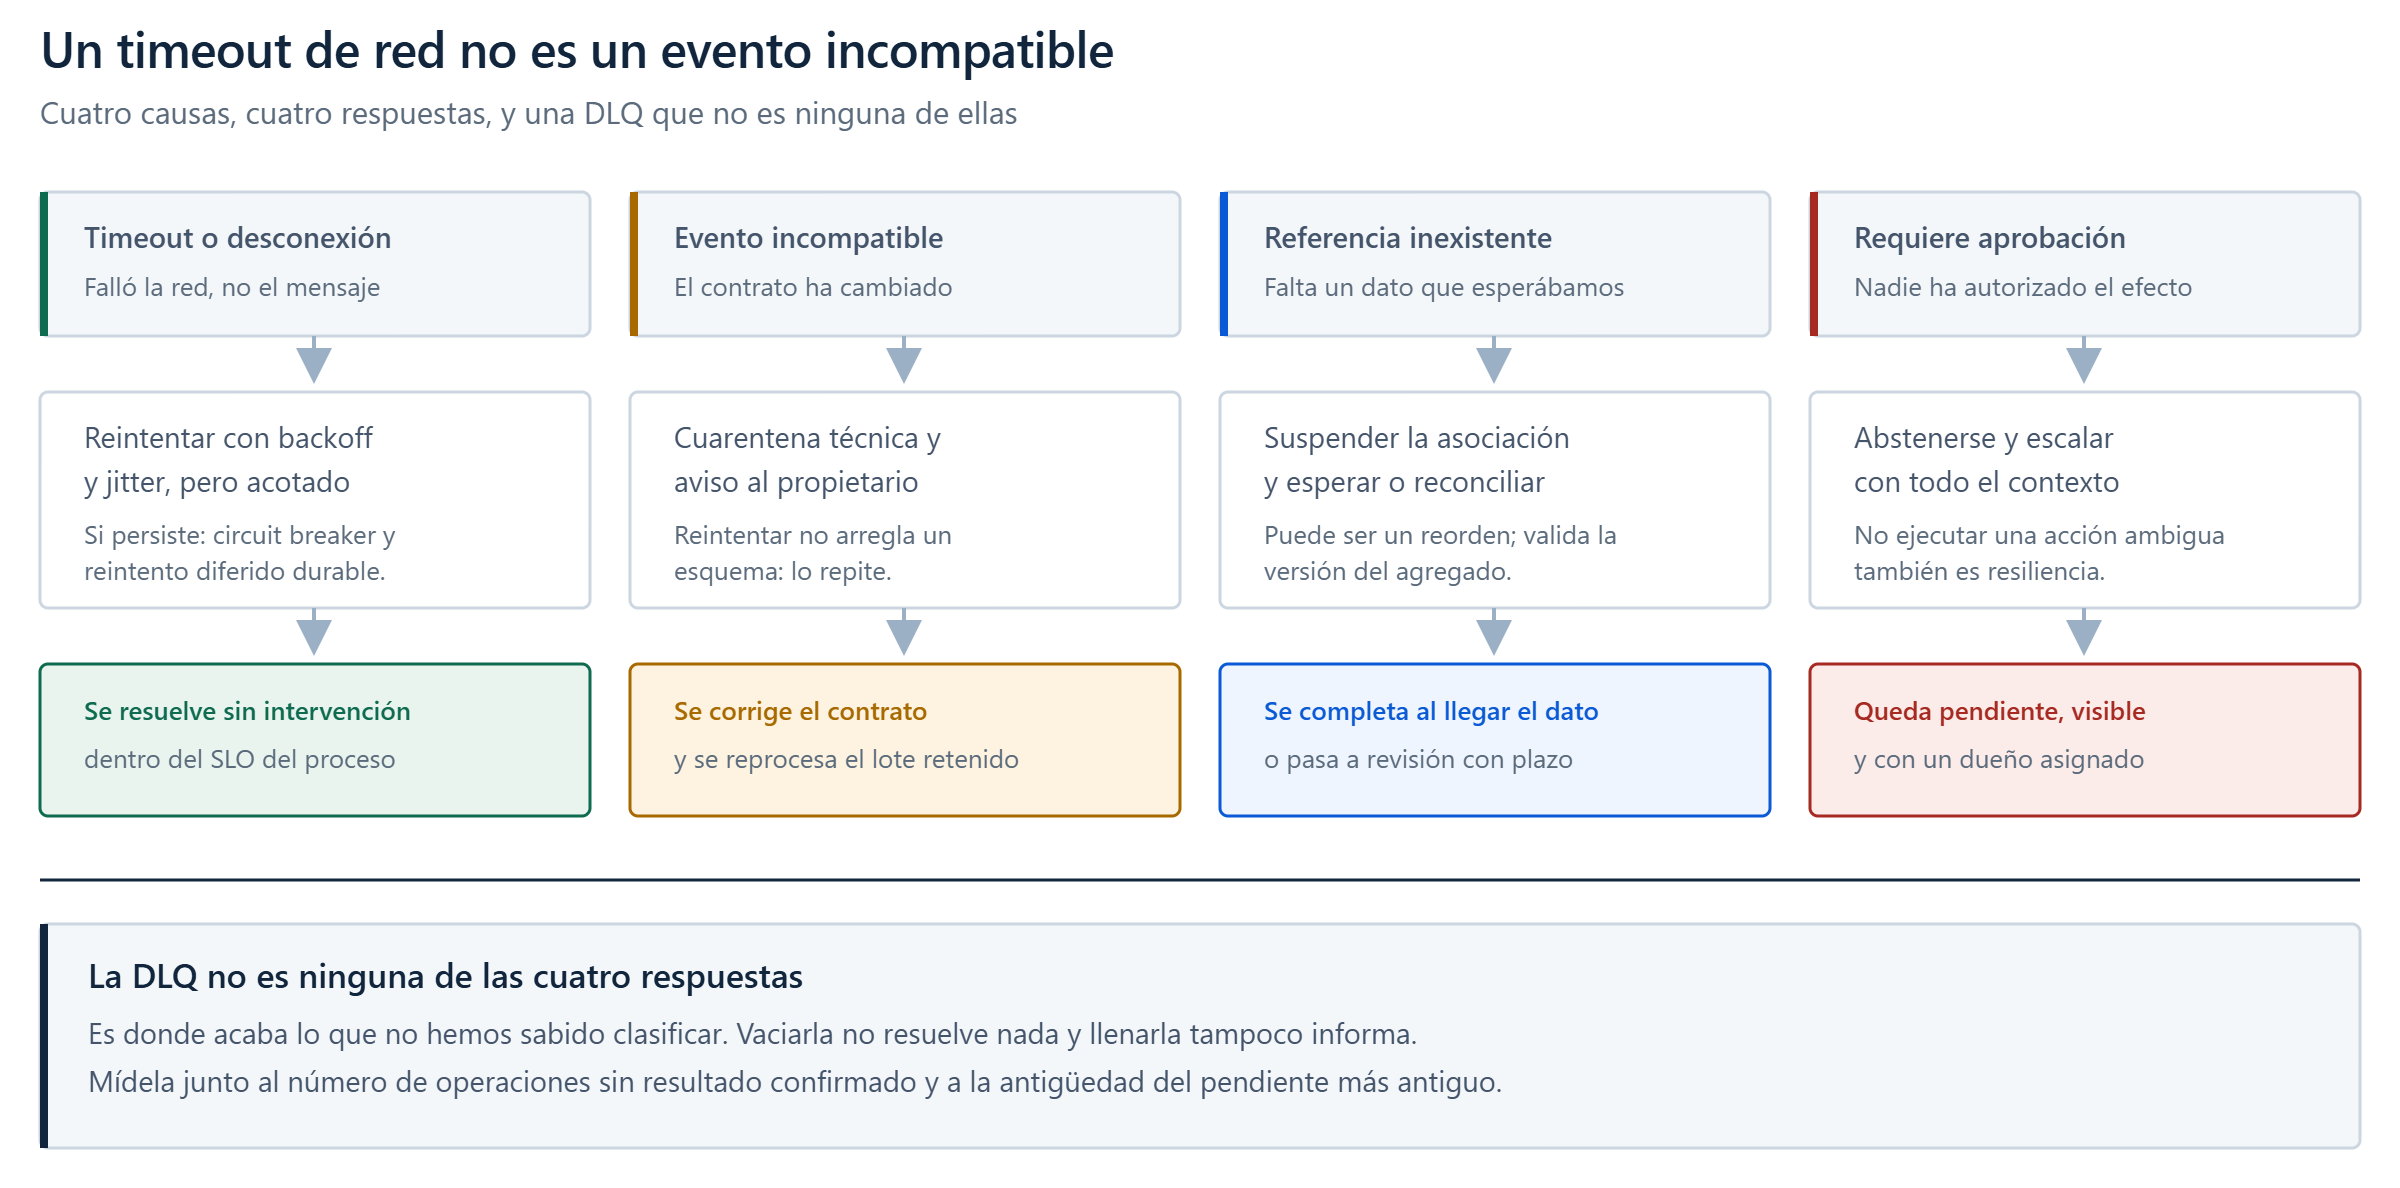
Mantendría un reconciliador que contraste OperationCreated, EventPublished, DestinationAccepted y OperationCompleted: no son sinónimos.
5. ¿Actores con estado? Sí, cuando el dominio lo pida
Evaluaría Microsoft Orleans y Dapr Actors para agregados con concurrencia y estado propio. Un actor por RequestId puede secuenciar Created → Validated → Dispatched → Completed, pero no elimina Outbox, Inbox ni las transacciones de persistencia.
- Orleans Grain Persistence permite persistir estado mediante proveedores.
- Dapr Actors aporta identidad y recordatorios persistentes bajo las condiciones del state store.
- Durable Functions / Durable Task encaja mejor para workflows de larga duración que esperan respuestas de varios sistemas.
No crearía actores para reemplazar una cola. No usaría una Saga si una única transacción ACID resuelve el problema. Y nunca presupongo que una compensación puede deshacer un efecto irreversible.
6. Azure: SLA, RTO, RPO y SLO pertenecen a capas distintas
Un SLA es un compromiso contractual de disponibilidad bajo determinadas condiciones. RTO es el tiempo objetivo de recuperación; RPO, la pérdida máxima de datos tolerable; SLO, el comportamiento operativo objetivo del servicio completo. Contratar un servicio con SLA no demuestra el RTO o el RPO de tu proceso de negocio.
| Servicio / configuración | Qué aporta | Qué no demuestra |
|---|---|---|
| Azure SQL con redundancia zonal | RPO 0 para datos confirmados ante caída de una zona y recuperación habitualmente rápida, según documentación. | No asegura RPO 0 ante pérdida regional ni recuperación completa de todas las dependencias. |
| Azure SQL Failover Groups | Opción de recuperación regional. | Al ser la replicación geográfica asíncrona puede perderse lo aún no replicado. |
| Service Bus Premium en región con zonas | SLA anunciado del 99,99 % desde el 1 de mayo de 2026. | No es el SLA de una aplicación, ni constituye archivo histórico de mensajes. |
| Service Bus Geo-Replication | Opciones síncronas y asíncronas según requisitos. | El RPO depende del modo y de la topología elegida. |
| AKS con zonas | Distribución, reinicios y mecanismos de continuidad de cómputo. | El SLA del control plane no equivale al SLA de los pods ni al del negocio. |
| Azure Monitor + OpenTelemetry | Evidencia sobre latencia, errores, backlog y recuperación. | La monitorización no sustituye la persistencia ni un DR plan. |
La documentación de Azure SQL distingue alta disponibilidad zonal de recuperación geográfica: para failover groups indica recuperación típica inferior a 60 segundos del servicio de base de datos, pero advierte de posibles transacciones no replicadas. Microsoft anunció el SLA 99,99 % de Service Bus Premium para regiones con zonas, sin exigir ya particionamiento.
La revisión de arquitectura exige presupuestos de RTO/RPO por proceso, pruebas de failover, tiempos de recuperación de backlog y procedimientos de continuidad, no una suma de logos Azure.
7. Libreritis: el software que no controlamos también es deuda
Hasta aquí hemos hablado del software que escribimos nosotros. El resto del artículo trata del que no escribimos y seguimos firmando.
Una librería para el comando, otra para su handler, otra para mapear, otra para validar y otra para imprimir resultados. Lo veo una y otra vez. El proyecto acaba delegando decisiones esenciales a una pirámide de paquetes y dependencias transitivas.
Mi regla orientativa del 80 % no es un KPI numérico: primero construir el dominio y la estructura de aplicación con C#, APIs nativas de .NET y SDK oficiales; añadir una dependencia externa cuando su beneficio supera claramente el coste de mantenerla. El equipo de arquitectura debe construir la referencia funcional mínima, inyectar fallos y comparar soluciones antes de estandarizar un framework.
No significa reinventar TLS, criptografía, bases de datos o protocolos distribuidos. Eso suele ser una mala idea. Significa que nuestro dominio, nuestros contratos y nuestras decisiones no deben pertenecer a un framework.
MediatR: el patrón Mediator no es durabilidad
MediatR puede ayudar a organizar peticiones locales. Pero no aporta por sí mismo un Outbox, un Inbox, persistencia de mensajes ni recuperación entre procesos. Tampoco CQRS obliga a usar un dispatcher. Un CreateBusinessRequestHandler llamado directamente desde ASP.NET Core puede ser más explícito y suficiente.
Además, MediatR 13+ tiene un modelo de licencia distinto respecto de las versiones anteriores. No es un reproche a su autor: es un recordatorio de que una licencia y una API pública son dependencias arquitectónicas.
Mi selección de librerías y componentes .NET
| Necesidad | Opción que evaluaría | Criterio |
|---|---|---|
| DI y hosting | Microsoft.Extensions.DependencyInjection, Hosting | Punto de partida estándar; sin contenedor adicional por defecto. |
| APIs y handlers | ASP.NET Core + C# propio | Contratos y límites explícitos. |
| Concurrencia local | System.Threading.Channels |
Colas en memoria, nunca sustituto de durabilidad. |
| Serialización | System.Text.Json |
Prioridad a APIs estándar. |
| Persistencia | EF Core + Microsoft.Data.SqlClient | Transacciones controladas. |
| Transporte | Azure.Messaging.ServiceBus | SDK oficial, manejo claro de ACK y sesiones. |
| Identidad | Azure.Identity | Managed Identity cuando proceda. |
| Resiliencia HTTP | Microsoft.Extensions.Http.Resilience | Retry, timeouts y circuit breaker. |
| Observabilidad | OpenTelemetry .NET | Estándar abierto y correlación. |
| Reverse proxy | YARP | Strangler Fig controlado. |
| Orquestación | Durable Task .NET | Progreso durable y recuperación. |
| Actores | Orleans, Dapr Actors | Solo si hay necesidad real de estado y concurrencia. |
| Mensajería durable | Wolverine, MassTransit, NServiceBus | Comparar contratos de recuperación, licencias y soporte. |
Wolverine es una alternativa abierta interesante para Outbox/Inbox; MassTransit 9 requiere licencia y NServiceBus es comercial. Una solución especializada puede reducir riesgos mejor que nuestro código propio, pero lo demostraría mediante tests de pérdida de ACK, duplicados, failover y transacciones.
¿Qué pasa si desaparece una librería, cambia su licencia o deja de mantenerla alguien?
Una versión adquirida legítimamente bajo MIT mantiene normalmente los derechos concedidos por esa licencia aunque futuras versiones cambien de condiciones. Eso no garantiza soporte, parches, compatibilidad ni continuidad de publicación. Además, MIT no incluye una concesión expresa de patentes como Apache-2.0. Texto MIT.
Necesitamos inventario de dependencias directas y transitivas, lockfiles, análisis de licencias, SBOM, presupuesto de mantenimiento y un plan de sustitución para dependencias estratégicas. En .NET usaría Central Package Management, packages.lock.json, dotnet restore --locked-mode y NuGet Audit. En frontend, npm ci y lockfiles revisados.
Un paquete de terceros que no podemos sustituir puede convertirse en el siguiente legacy, aunque nuestra aplicación tenga microservicios y despliegue en Kubernetes.
8. Supply chain: ¿sabemos qué código se está ejecutando realmente?
Este es el problema que veo una y otra vez: sabemos qué repositorio tenemos, pero no podemos demostrar qué binario exacto terminó en producción, con qué dependencias se construyó, quién autorizó el despliegue o si alguien cambió la imagen por otra con la misma etiqueta.
También ocurre con componentes internos: un NuGet corporativo publicado desde un portátil, una imagen base compartida, un paquete npm privado con permisos de publicación excesivos o un runner que conserva secretos. Que una dependencia sea interna no significa que sea confiable.
Log4Shell: un ejemplo mayor de lo que ocurre cuando no conocemos nuestras dependencias
En diciembre de 2021 se divulgó CVE-2021-44228, Log4Shell, una vulnerabilidad crítica de ejecución remota en Apache Log4j 2, concretamente en log4j-core bajo condiciones vulnerables. La organización podía no haber elegido Log4j directamente: podía venir incorporado en frameworks, productos, herramientas o componentes de terceros.
Precisión importante: Log4Shell no afectó a log4net. Los nombres son parecidos, pero no es el mismo producto ni la misma vulnerabilidad. La Apache Software Foundation y NVD lo indican explícitamente.
El problema de fondo para el equipo de operaciones era brutal: ¿qué aplicaciones lo incluyen?, ¿en qué versión?, ¿lo tenemos embebido dentro de un producto comercial?, ¿qué imagen contiene la biblioteca?, ¿qué clientes están expuestos?, ¿qué instancia concreta hay que retirar o actualizar? Sin inventario ni SBOM, descubrirlo puede convertirse en una búsqueda manual sobre decenas de sistemas mientras existe presión por actuar.
Log4Shell demuestra que una librería aparentemente secundaria —logging— puede acabar definiendo la superficie de ataque de toda una organización. No demuestra que las dependencias abiertas sean malas: demuestra el peligro de consumir software sin saber qué contiene realmente.
Más ejemplos conocidos: SolarWinds, donde un proceso de distribución comprometido produjo actualizaciones firmadas legítimamente; Codecov, donde se comprometió una herramienta usada en CI; y XZ Utils (CVE-2024-3094), que mostró el peligro de las dependencias de bajo nivel.
Ataques y errores internos que debemos contemplar
| Escenario | Consecuencia | Control recomendado |
|---|---|---|
| Dependency confusion en feeds NuGet/npm | Se resuelve un paquete público que suplanta a uno interno. | Mapeo explícito de fuentes, feeds controlados, revisión de paquete. |
| Cuenta CI con permisos excesivos | Puede publicar paquetes o desplegar imágenes no autorizadas. | OIDC, identidades efímeras, mínimo privilegio, entornos protegidos. |
| Acción de GitHub mutable | El contenido del workflow cambia sin tocar la aplicación. | Pinning por SHA y revisión de dependencias del pipeline. |
Imagen Docker/OCI etiquetada latest |
Se despliega contenido distinto del probado. | Deploy por digest inmutable. |
| Feed interno que permite sobreescritura | Se pierde la identidad del paquete aprobado. | Inmutabilidad y trazabilidad de promoción. |
| Runner compartido con secretos | Una tarea puede acceder a credenciales residuales. | Runners aislados/efímeros y segregación por confianza. |
| Paquete sugerido por IA sin verificación | Riesgo de dependencia inexistente o maliciosa. | Validar origen, publicador, versión, código y licencia. |
La IA añade un vector interesante: una sugerencia convincente de instalación no demuestra que el paquete exista, sea el correcto o tenga el mantenedor esperado. La validación de dependencias es aún más importante si la generación de código está automatizada.
La cadena que exigiría
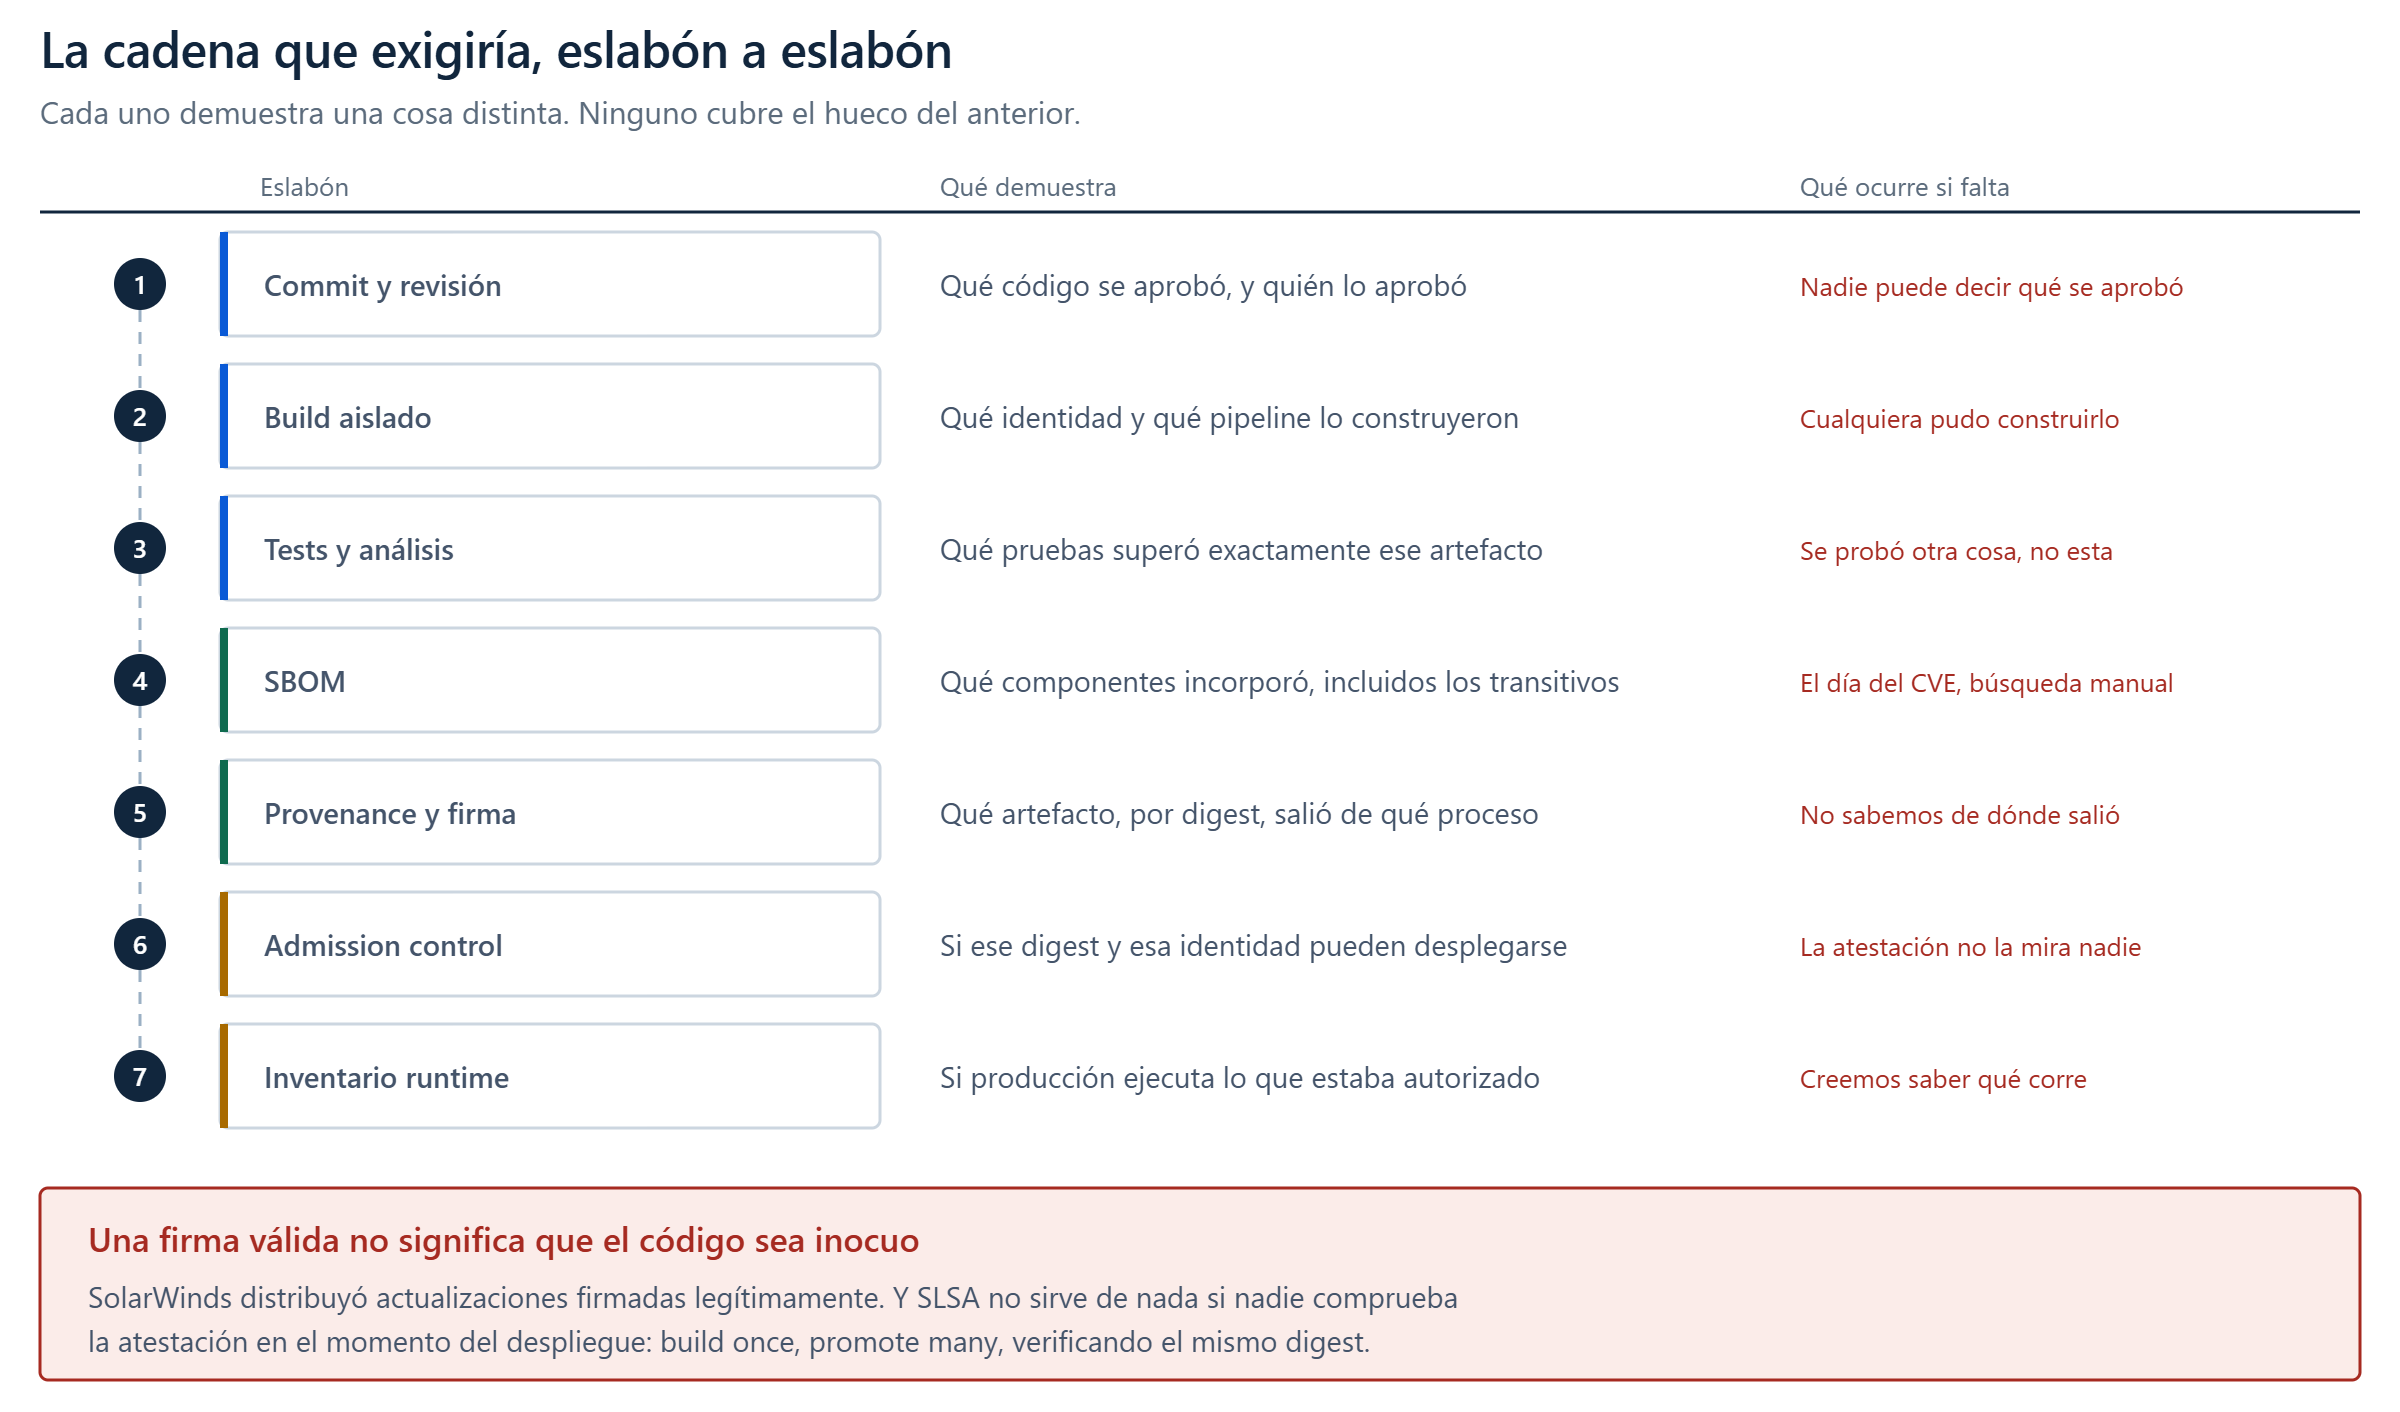
Usaría SLSA, GitHub Artifact Attestations, Sigstore Cosign o Notation según el escenario. En Azure, ACR + Key Vault + políticas de admisión con Ratify/Azure Policy pueden formar parte de una cadena de confianza verificable, sujeta a compatibilidad y soporte de la configuración elegida. Documentación Ratify en AKS.
Cada eslabón tiene una función diferente:
- Commit y revisión: qué código se aprobó.
- Build aislado: qué identidad y qué pipeline construyeron.
- Tests y análisis: qué pruebas superó exactamente ese artefacto.
- SBOM: qué componentes incorporó.
- Provenance y firma: qué artefacto (digest) salió de qué proceso.
- Admission control: si ese digest y esa identidad están autorizados a desplegarse.
- Inventario runtime: si lo que ejecuta producción coincide con lo autorizado.
Una firma válida no significa que el código sea inocuo: SolarWinds lo demostró. Se necesita combinar procedencia, aislamiento de build, análisis, revisión y verificación en despliegue. SLSA no sirve si nadie comprueba la atestación.
El fragmento siguiente ilustra la atestación de un binario en GitHub Actions. La versión de la action, permisos y plan de GitHub deben revisarse; en un repositorio de producción fijaría acciones por SHA:
permissions:
  contents: read
  id-token: write
  attestations: write

steps:
  - name: Build
    run: dotnet publish src/Business.Api -c Release -o publish

  - name: Attest build provenance
    uses: actions/attest@v4 # En producción: fijar al SHA revisado
    with:
      subject-path: 'publish/**'
Y para despliegues OCI, la identidad debe ser el digest, no una etiqueta mutable:
containers:
  - name: business-api
    image: acr.example.com/business-api@sha256:<DIGEST_VALIDADO>
Ese SHA no es una firma por sí mismo; la política debe verificar además quién construyó y atestó el artefacto. Para un pipeline empresarial quiero build once, promote many, verificando el mismo digest a lo largo de los entornos.
9. Testing: no quiero cien mocks, quiero demostrar las garantías
Los tests unitarios siguen siendo fundamentales, pero no prueban una caída después de un commit y antes del ACK. Una arquitectura resiliente exige pruebas de integración, contratos, carga y caos.
Mi selección de herramientas de testing
| Necesidad | Herramienta | Criterio |
|---|---|---|
| Ejecución estándar | dotnet test |
Integración sencilla con CI. |
| Framework | MSTest o xUnit | Elegir uno; no tres por moda. |
| Aserciones y dobles | Nativas + fakes en C# | Evitar sobreespecificar llamadas internas. |
| Tiempo controlado | FakeTimeProvider | Retries y timers deterministas. |
| Integración ASP.NET | WebApplicationFactory | Probar endpoints y DI real. |
| BBDD y broker efímeros | Testcontainers .NET | Contenedores reales, runtime compatible. |
| APIs externas | WireMock.Net | Simular latencia, 429, 503 y contratos. |
| UI end-to-end | Playwright .NET | Navegadores reales cuando haga falta. |
| Benchmarks locales | BenchmarkDotNet | Medidas de componentes, no del sistema entero. |
| Carga distribuida | Azure Load Testing | Throughput, p95/p99 y backlog. |
| Inyección de fallos | Azure Chaos Studio | Experimentos controlados y reversibles. |
| Cobertura | dotnet-coverage | Cobertura no equivale a calidad. |
| Snapshot testing | Verify | Evaluar complejidad y condiciones de uso de versiones concretas. |
Verify es además un ejemplo perfecto de gobernanza de licencias en testing. Según su README oficial, las versiones oficiales publicadas después del 1 de septiembre de 2026 se someten a una Open Source Maintenance Fee para organizaciones que generan ingresos y administraciones públicas; el código fuente sigue estando disponible bajo sus condiciones de licencia. No significa que toda versión anterior haya cambiado de licencia retroactivamente. Sí significa que el área de arquitectura y compras necesita mirar también las dependencias de pruebas.
Una librería de tests corre dentro del pipeline y puede acceder a recursos de build; no deberíamos concederle un nivel de confianza superior por llamarse «dev dependency». El incidente de Codecov es una buena advertencia.
Mi campaña mínima de resiliencia
| Fallo inyectado | Evidencia de PASS |
|---|---|
| Consumidor muere antes del commit | Se reentrega y se procesa una vez en cuanto a efecto. |
| Muere después del commit y antes de ACK | El Inbox impide un segundo efecto. |
| Broker no disponible una hora | Outbox conserva pendiente y se recupera dentro del SLO. |
| Dos workers reclaman la misma fila | No se pierde el evento; los duplicados son tolerados. |
| Orden de eventos invertido | Versionado y reglas evitan estado inválido. |
| Respuesta ambigua de API externa | Reconciliación antes de repetir un efecto irreversible. |
| Fallo regional | Se miden RTO/RPO reales y se ejecuta el runbook. |
| Imagen no firmada / identidad no confiable | El admission control deniega el despliegue. |
| SBOM señala una dependencia vulnerable | Se localizan artefactos y despliegues afectados. |
Guardaría la evidencia: hypothesis → fault → expected invariant → observed outcome → timings → artefactos/logs → PASS/FAIL. Una prueba que demuestra que el pod volvió a arrancar no demuestra que no se duplicó una operación.
10. El equipo de arquitectura debe fabricar evidencias, no imponer LEGO
El equipo de arquitectura no debería limitarse a decidir «usaremos esta librería» o «el estándar de la organización es Kafka». Primero construimos un vertical slice funcional, con el mínimo de piezas: API, dominio, una transacción, Outbox, broker, Inbox, telemetría y pruebas de fallo. Después contrastamos mantenerlo con SDK oficiales frente a introducir Wolverine, MassTransit o NServiceBus. El criterio no es el número de clases, sino el coste total, la capacidad de evolucionar y las garantías observadas.
Cada decisión transversal debe producir un ADR con contexto, alternativas, riesgos, reversibilidad y evidencias. Mi monográfico sobre ADRs profundiza precisamente en esa disciplina.
Añado otra regla: no pondría un componente en el catálogo corporativo si no puedo explicar cómo actualizarlo, cómo sustituirlo, cómo escanearlo, cómo desplegarlo de forma verificada y cómo recuperar el proceso que depende de él.
11. Decommission by evidence: modernizar también es saber qué retirar
Una modernización no termina cuando el nuevo servicio responde bien en un entorno de prueba. Termina cuando retiramos las dependencias antiguas sin crear nuevos agujeros de consistencia, seguridad y operación.
Para declarar una capacidad realmente migrada exigiría: contratos verificados, datos reconciliados, procesos batch y accesos SQL legacy eliminados o controlados, pruebas de failover, runbooks, RTO/RPO medidos, dependencias inventariadas y el digest y procedencia de los artefactos en producción.
Si no retiramos la dependencia del monolito, solo hemos colocado otra capa. Si no sabemos qué ejecutamos, podemos haber construido un legacy moderno con una cadena de suministro opaca.
12. Y ahora entra la IA: los fundamentos son la base
Todo esto puede parecer una discusión sobre patrones antiguos. Para mí es justamente lo contrario: es la discusión que debemos tener antes de delegar más trabajo a agentes de IA.
La IA puede generar un handler, escribir un test, configurar un workflow o proponer una dependencia. Pero no conoce automáticamente nuestros límites transaccionales, nuestro RPO aceptable, las políticas de privacidad, el significado de un evento, la legitimidad de un paquete npm ni las consecuencias de repetir una operación irreversible.
Si entregamos a la IA una arquitectura confusa, decisiones no documentadas, contratos implícitos y un pipeline sin controles, podemos obtener esa misma confusión a mayor velocidad. Si trabajamos con dominio explícito, criterios de aceptación, ADRs, pruebas reproducibles y verificaciones de procedencia, la IA puede ayudarnos a producir mucho mejor software y reducir trabajo mecánico sin perder el control.
Esto no quiere decir que quien desarrollaba software mediocre esté condenado a seguir haciéndolo: la IA también puede enseñar y elevar el nivel. Pero esa mejora no es automática. Requiere criterio técnico, revisión, aprendizaje y responsabilidad humana.
Construir software no es juntar piezas de LEGO hasta que compila. Es conocer las fuerzas que sostienen el edificio: datos, seguridad, operación, diseño, equipos, costes, compatibilidad, observabilidad y recuperación.
Por eso cierro con una frase propia:
«La IA amplifica nuestra capacidad de construir software, pero no sustituye el criterio que nos permite saber si está bien construido. Sin fundamentos, solo automatizamos la incertidumbre».
— José María Flores Zazo
El Manifiesto por el Software Craftsmanship sigue siendo una buena brújula: no basta con que el software funcione; importa cómo está construido y si sigue aportando valor cuando cambian los requisitos, los equipos y la tecnología.
Menos dependencia del legacy. Menos libreritis. Menos estados ambiguos. Más control sobre lo que escribimos y desplegamos. Más recuperación demostrable. Más evidencia.
Referencias esenciales
Patrones y arquitectura: Strangler Fig · Anti-Corruption Layer · Cloud Design Patterns · ADR — José María Flores Zazo.
Azure y recuperación: Azure SQL Business Continuity · Service Bus Reliability · Service Bus Premium SLA 2026.
Supply chain: NVD Log4Shell · Apache Log4j CVEs · SLSA · GitHub Attestations · Ratify/Azure Policy.
Librerías y testing: Orleans · Dapr Actors · Wolverine · MediatR licensing · Verify licensing · Testcontainers.
Nota: los SLA y comportamientos citados corresponden a configuraciones concretas documentadas. Los objetivos de recuperación de un sistema completo deben probarse en su topología real, incluidas dependencias y operación humana.