
Gobernar el tráfico no es gobernar el ciclo de vida del agente
Durante los últimos meses hemos convertido la expresión gobernar la IA en una etiqueta demasiado cómoda.
Llamamos gobierno a poner un proxy delante del modelo. Llamamos gobierno a tener un dashboard de tokens. Llamamos gobierno a que el equipo de plataforma sea el único que conoce la clave.
El problema no es únicamente terminológico.
Cuando confundimos la frontera de red con la frontera de autoridad, terminamos desplegando una pieza correcta y respondiendo mal a las preguntas que importan:
- ¿Qué aplicación ha invocado este modelo?
- ¿Con qué identidad?
- ¿Qué herramientas podía alcanzar esa misma credencial?
- ¿Qué política estaba activa cuando se produjo la llamada?
- ¿Quién cambió esa política, cuándo y contra qué revisión?
- ¿Qué ocurre cuando la ejecución de un agente no termina limpiamente?
- ¿Podemos reconstruir lo sucedido sin depender de la memoria de nadie?
El nuevo AI Gateway tier de Azure API Management responde bien a varias de ellas. A otras no responde, y conviene saber a cuáles antes de dibujarlo en una diapositiva de arquitectura corporativa.
AI Gateway no convierte el tráfico en gobierno. Convierte el tráfico en un punto donde el gobierno es posible.
No es la misma frase.
Qué es realmente, y qué no
AI Gateway tier es un recurso dedicado de Azure API Management, hoy en vista previa pública. Su plano de control está organizado alrededor de modelos, servidores MCP y herramientas, en lugar de APIs, y se administra desde un portal independiente, no desde el portal de Azure.
Tres consecuencias arquitectónicas inmediatas.
La primera: no sustituye a API Management. Se construyó como una experiencia separada, y los niveles clásico y v2 conservan las capacidades de AI gateway que ya tenían. Si tu organización ya tiene un gateway de IA montado sobre Premium o Standard v2, la pregunta de convivencia sigue abierta.
La segunda: las políticas dejan de ser XML. Se configuran como tarjetas en el portal, y el conjunto actual cubre content safety, filtro de IP, límite de tokens por minuto y límite de peticiones por minuto. El anuncio de lanzamiento menciona además cuotas de tokens y fallback a un modelo secundario, así que el catálogo de tarjetas se está moviendo. Compruébalo en tu tenant antes de diseñar sobre ello.
La tercera, y la que más me interesa: el gateway deja de ser un lugar donde escribes lógica. Eso es bueno para la velocidad de adopción. Es incómodo para la reproducibilidad, y volveré sobre ello.
El flujo de una petición
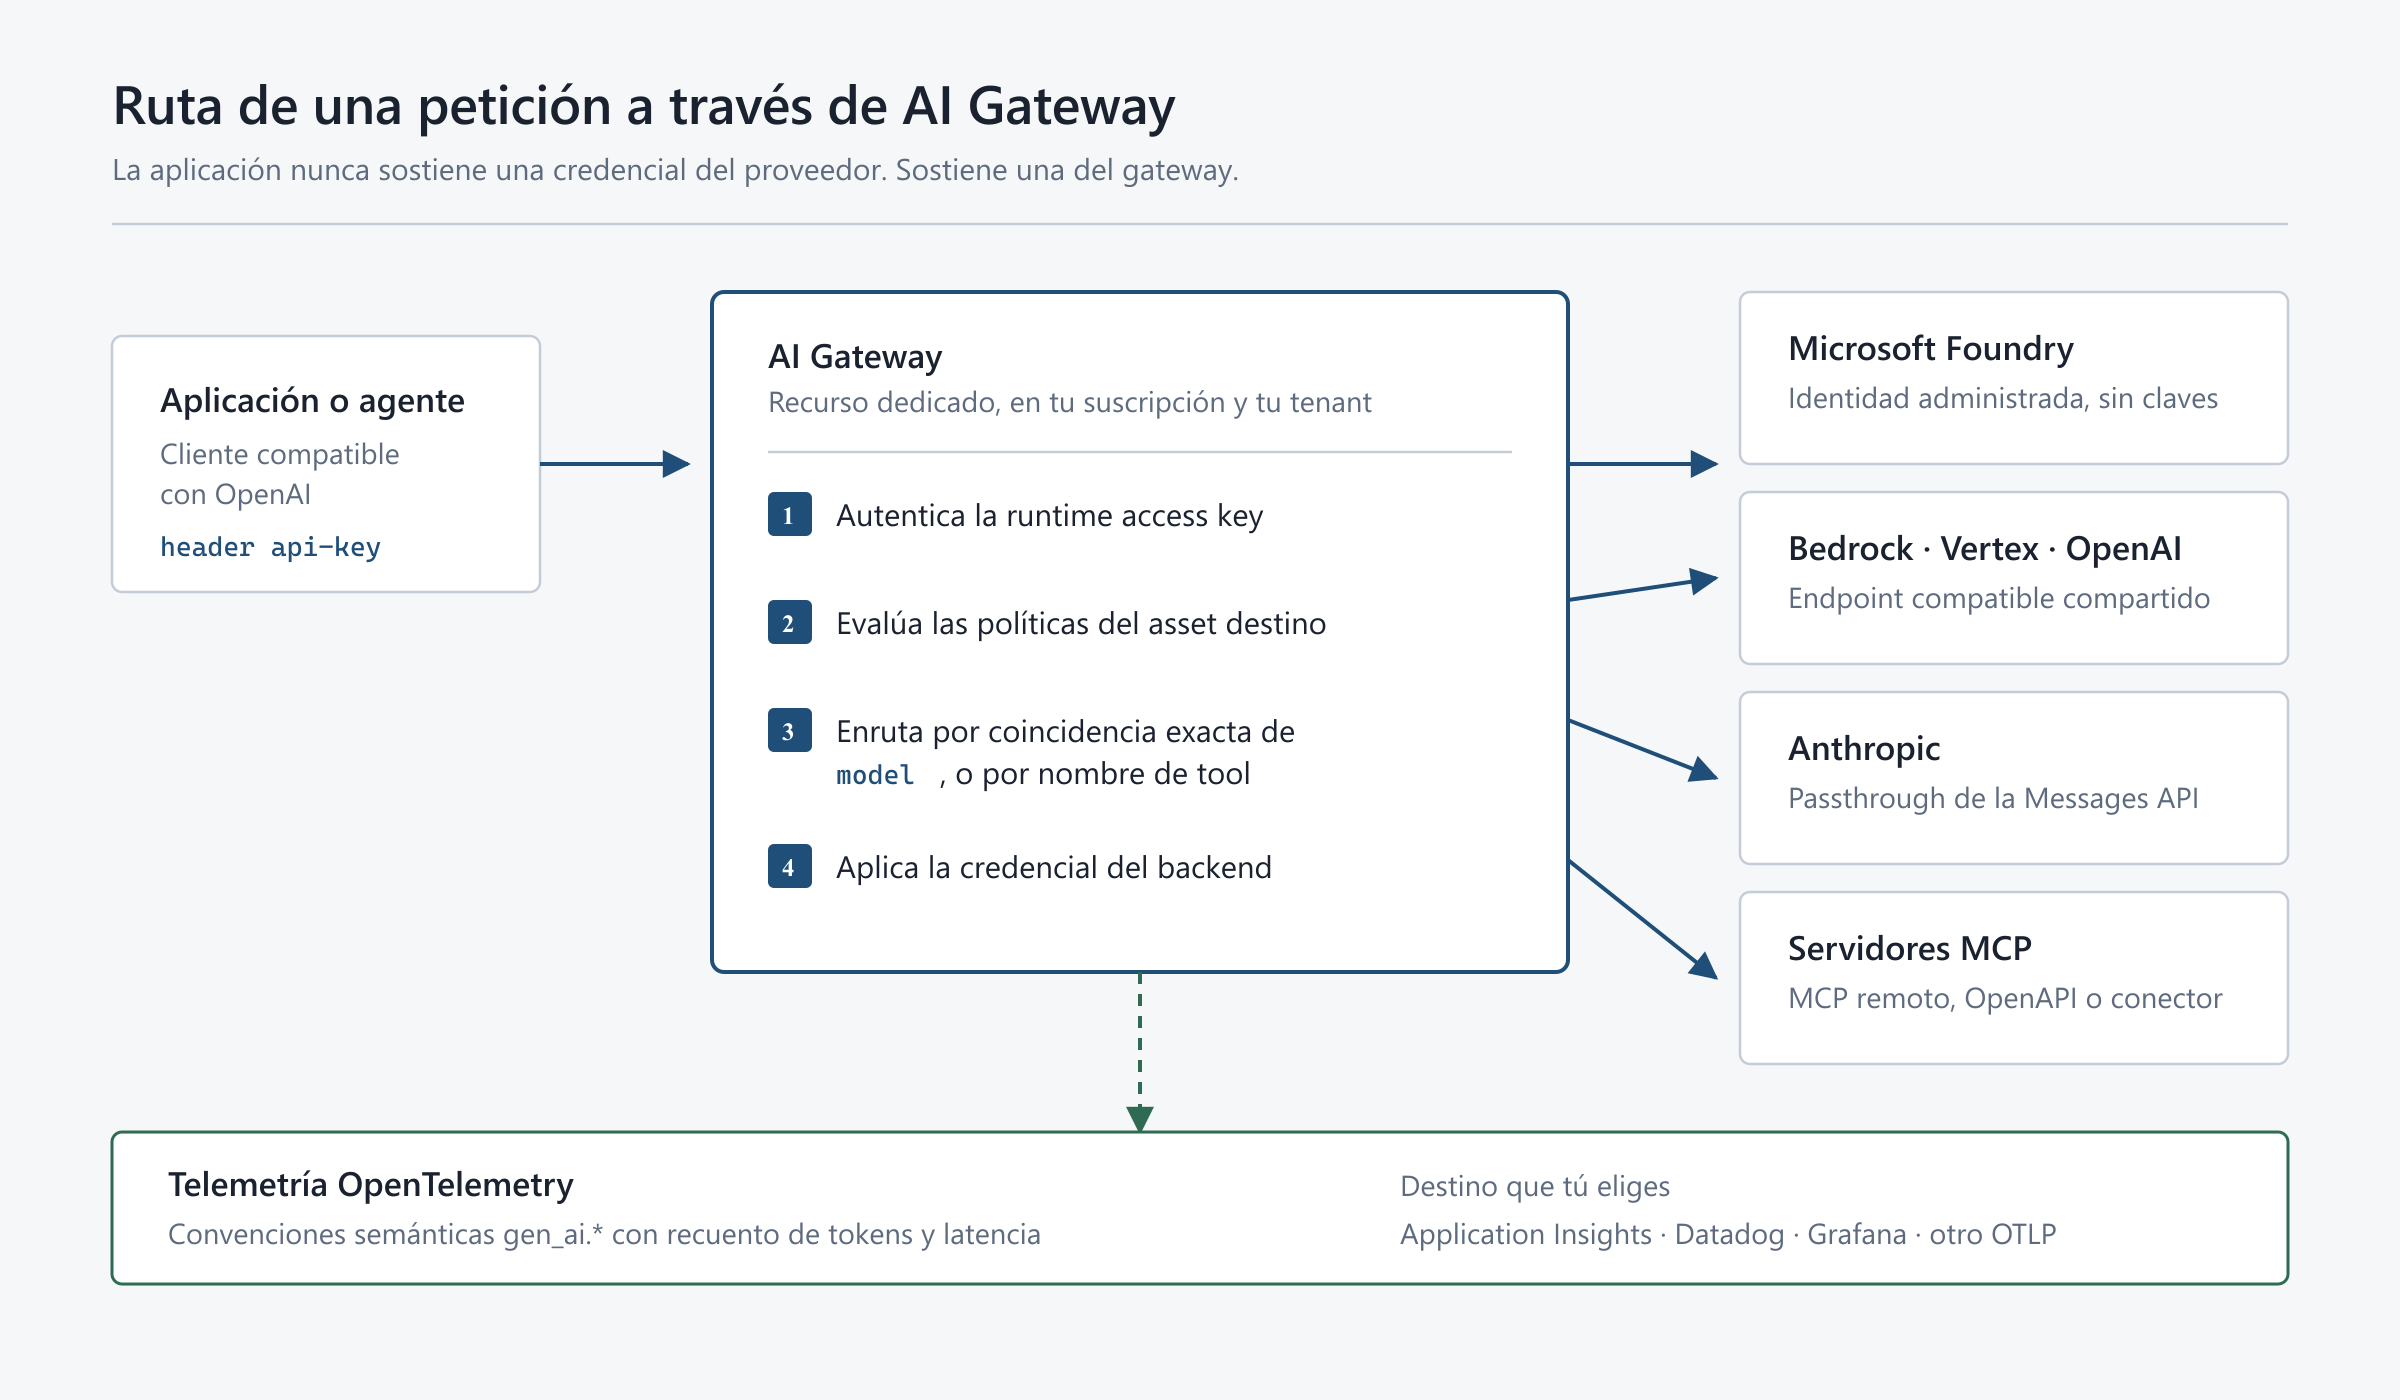
Los proveedores compatibles con OpenAI comparten un único endpoint y el enrutado se hace por coincidencia exacta del campo model, de modo que cada modelo publicado necesita un nombre único. Anthropic se expone mediante un proveedor personalizado con passthrough de la Messages API.
El detalle del nombre único no es cosmético. Es un espacio de nombres compartido entre equipos. En cuanto dos áreas publican su propio gpt-5.6, alguien va a renombrar el modelo de otro. Eso es una conversación de gobierno de plataforma, no un campo de un formulario.
Primero la infraestructura, y sin falsa reproducibilidad
El plano de datos sigue siendo Foundry. Lo despliego con Bicep, porque lo que no está declarado no es revisable.
infra/main.bicep:
targetScope = 'resourceGroup'

@description('Prefijo corto del workload. Se usa para componer los nombres.')
@minLength(3)
@maxLength(10)
param workload string = 'gwlab'

@allowed([ 'dev', 'pre', 'pro' ])
param environment string = 'dev'

@description('Región del recurso Foundry. No tiene por qué coincidir con la del gateway.')
param location string = resourceGroup().location

@description('Modelos a desplegar. Resuélvelos con scripts/00-check-models.sh ANTES de rellenar esto.')
param models array = []

@description('ObjectId del principal que recibirá el rol sobre Foundry. Vacío = no se asigna nada.')
param granteePrincipalId string = ''

@description('Role definition id (GUID). Resuélvelo en TU tenant; no lo fijes a ciegas.')
param roleDefinitionId string = ''

@description('Deshabilita las claves locales. true fuerza al gateway a entrar con identidad administrada.')
param disableLocalAuth bool = true

var suffix      = uniqueString(resourceGroup().id)
var foundryName = 'aif-${workload}-${environment}-${suffix}'

resource foundry 'Microsoft.CognitiveServices/accounts@2025-06-01' = {
  name: foundryName
  location: location
  kind: 'AIServices'
  sku: { name: 'S0' }
  identity: { type: 'SystemAssigned' }
  properties: {
    customSubDomainName:    foundryName
    allowProjectManagement: true
    disableLocalAuth:       disableLocalAuth
    publicNetworkAccess:    'Enabled'
    networkAcls: { defaultAction: 'Allow' }
  }
}

resource project 'Microsoft.CognitiveServices/accounts/projects@2025-06-01' = {
  name: 'proj-${workload}-${environment}'
  parent: foundry
  location: location
  identity: { type: 'SystemAssigned' }
}

module modelDeployments 'modules/model.bicep' = [for (model, i) in models: {
  name: 'model-${i}-${model.deploymentName}'
  params: {
    foundryAccountName: foundry.name
    deploymentName:     model.deploymentName
    modelName:          model.modelName
    modelVersion:       model.modelVersion
    modelFormat:        model.modelFormat
    skuName:            model.skuName
    capacity:           model.capacity
  }
  dependsOn: [ project ]
}]

resource grant 'Microsoft.Authorization/roleAssignments@2022-04-01' =
  if (!empty(granteePrincipalId) && !empty(roleDefinitionId)) {
    name: guid(foundry.id, granteePrincipalId, roleDefinitionId)
    scope: foundry
    properties: {
      principalId:      granteePrincipalId
      roleDefinitionId: subscriptionResourceId(
        'Microsoft.Authorization/roleDefinitions', roleDefinitionId)
    }
  }

output foundryAccountName string = foundry.name
output foundryEndpoint    string = foundry.properties.endpoint
output localAuthDisabled  bool   = disableLocalAuth
disableLocalAuth: true no es una preferencia estética.
Es la línea que obliga al gateway a entrar con identidad administrada, porque el asistente de importación ofrece dos caminos: basado en clave, donde el gateway guarda la clave de la cuenta y la envía en el header api-key, o identidad administrada, donde el asistente habilita una identidad de sistema si no existe y le concede el rol Foundry User sobre cada cuenta seleccionada.
Si dejas la autenticación local habilitada, el camino cómodo copia un secreto de larga vida a un plano de control que no es el tuyo. Si la deshabilitas, el camino cómodo desaparece y solo queda el correcto.
El despliegue del modelo va en su propio módulo, parametrizado:
param foundryAccountName string
param deploymentName     string
param modelName          string
param modelVersion       string
param modelFormat        string

@allowed([ 'GlobalStandard', 'Standard', 'DataZoneStandard', 'ProvisionedManaged' ])
param skuName string = 'GlobalStandard'

@minValue(1)
param capacity int = 50

resource account 'Microsoft.CognitiveServices/accounts@2025-06-01' existing = {
  name: foundryAccountName
}

resource deployment 'Microsoft.CognitiveServices/accounts/deployments@2025-06-01' = {
  name: deploymentName
  parent: account
  sku: { name: skuName, capacity: capacity }
  properties: {
    model: { name: modelName, format: modelFormat, version: modelVersion }
  }
}
Disponibilidad, versión, formato y SKU dependen de región, suscripción, cuota y catálogo. Fijarlos a mano en la plantilla es la forma más habitual de falsa reproducibilidad: compila, se despliega en tu portátil, y falla en el primer tenant ajeno.
En el repositorio, el fichero de parámetros viene con valores REEMPLAZAR a propósito. No debería poder desplegarse sin haber pasado por el paso cero.
Lo que no se despliega así
El gateway sí.
Se aprovisiona en aproximadamente un minuto, sin unidades de escala que planificar, y para automatización la versión de API de gestión en vista previa es 2026-05-01-preview.
Aquí está el primer compromiso honesto que debemos asumir: hoy la configuración real (modelos importados, servidores MCP, políticas, claves) se hace de forma natural por portal, sobre una superficie de API en preview que puede cambiar.
Una política que solo existe en un portal no es una política versionada. Es una decisión sin historial.
No digo que no la uses. Digo que mientras el plano de control no sea declarativo y estable, la pregunta aburrida sigue sin respuesta: ¿qué política estaba activa el martes a las 14:10, y quién la cambió? Ese hueco se tapa con disciplina de exportación periódica y con la telemetría, no con confianza.
Es exactamente el mismo patrón que describí al auditar agentes de Copilot: cuando el artefacto que gobierna no vive en git, te queda visibilidad forense, no prevención.
Identidad: tres credenciales con tres radios de explosión distintos
Esta es la parte del artículo que, si solo lees una sección, debería ser esta.
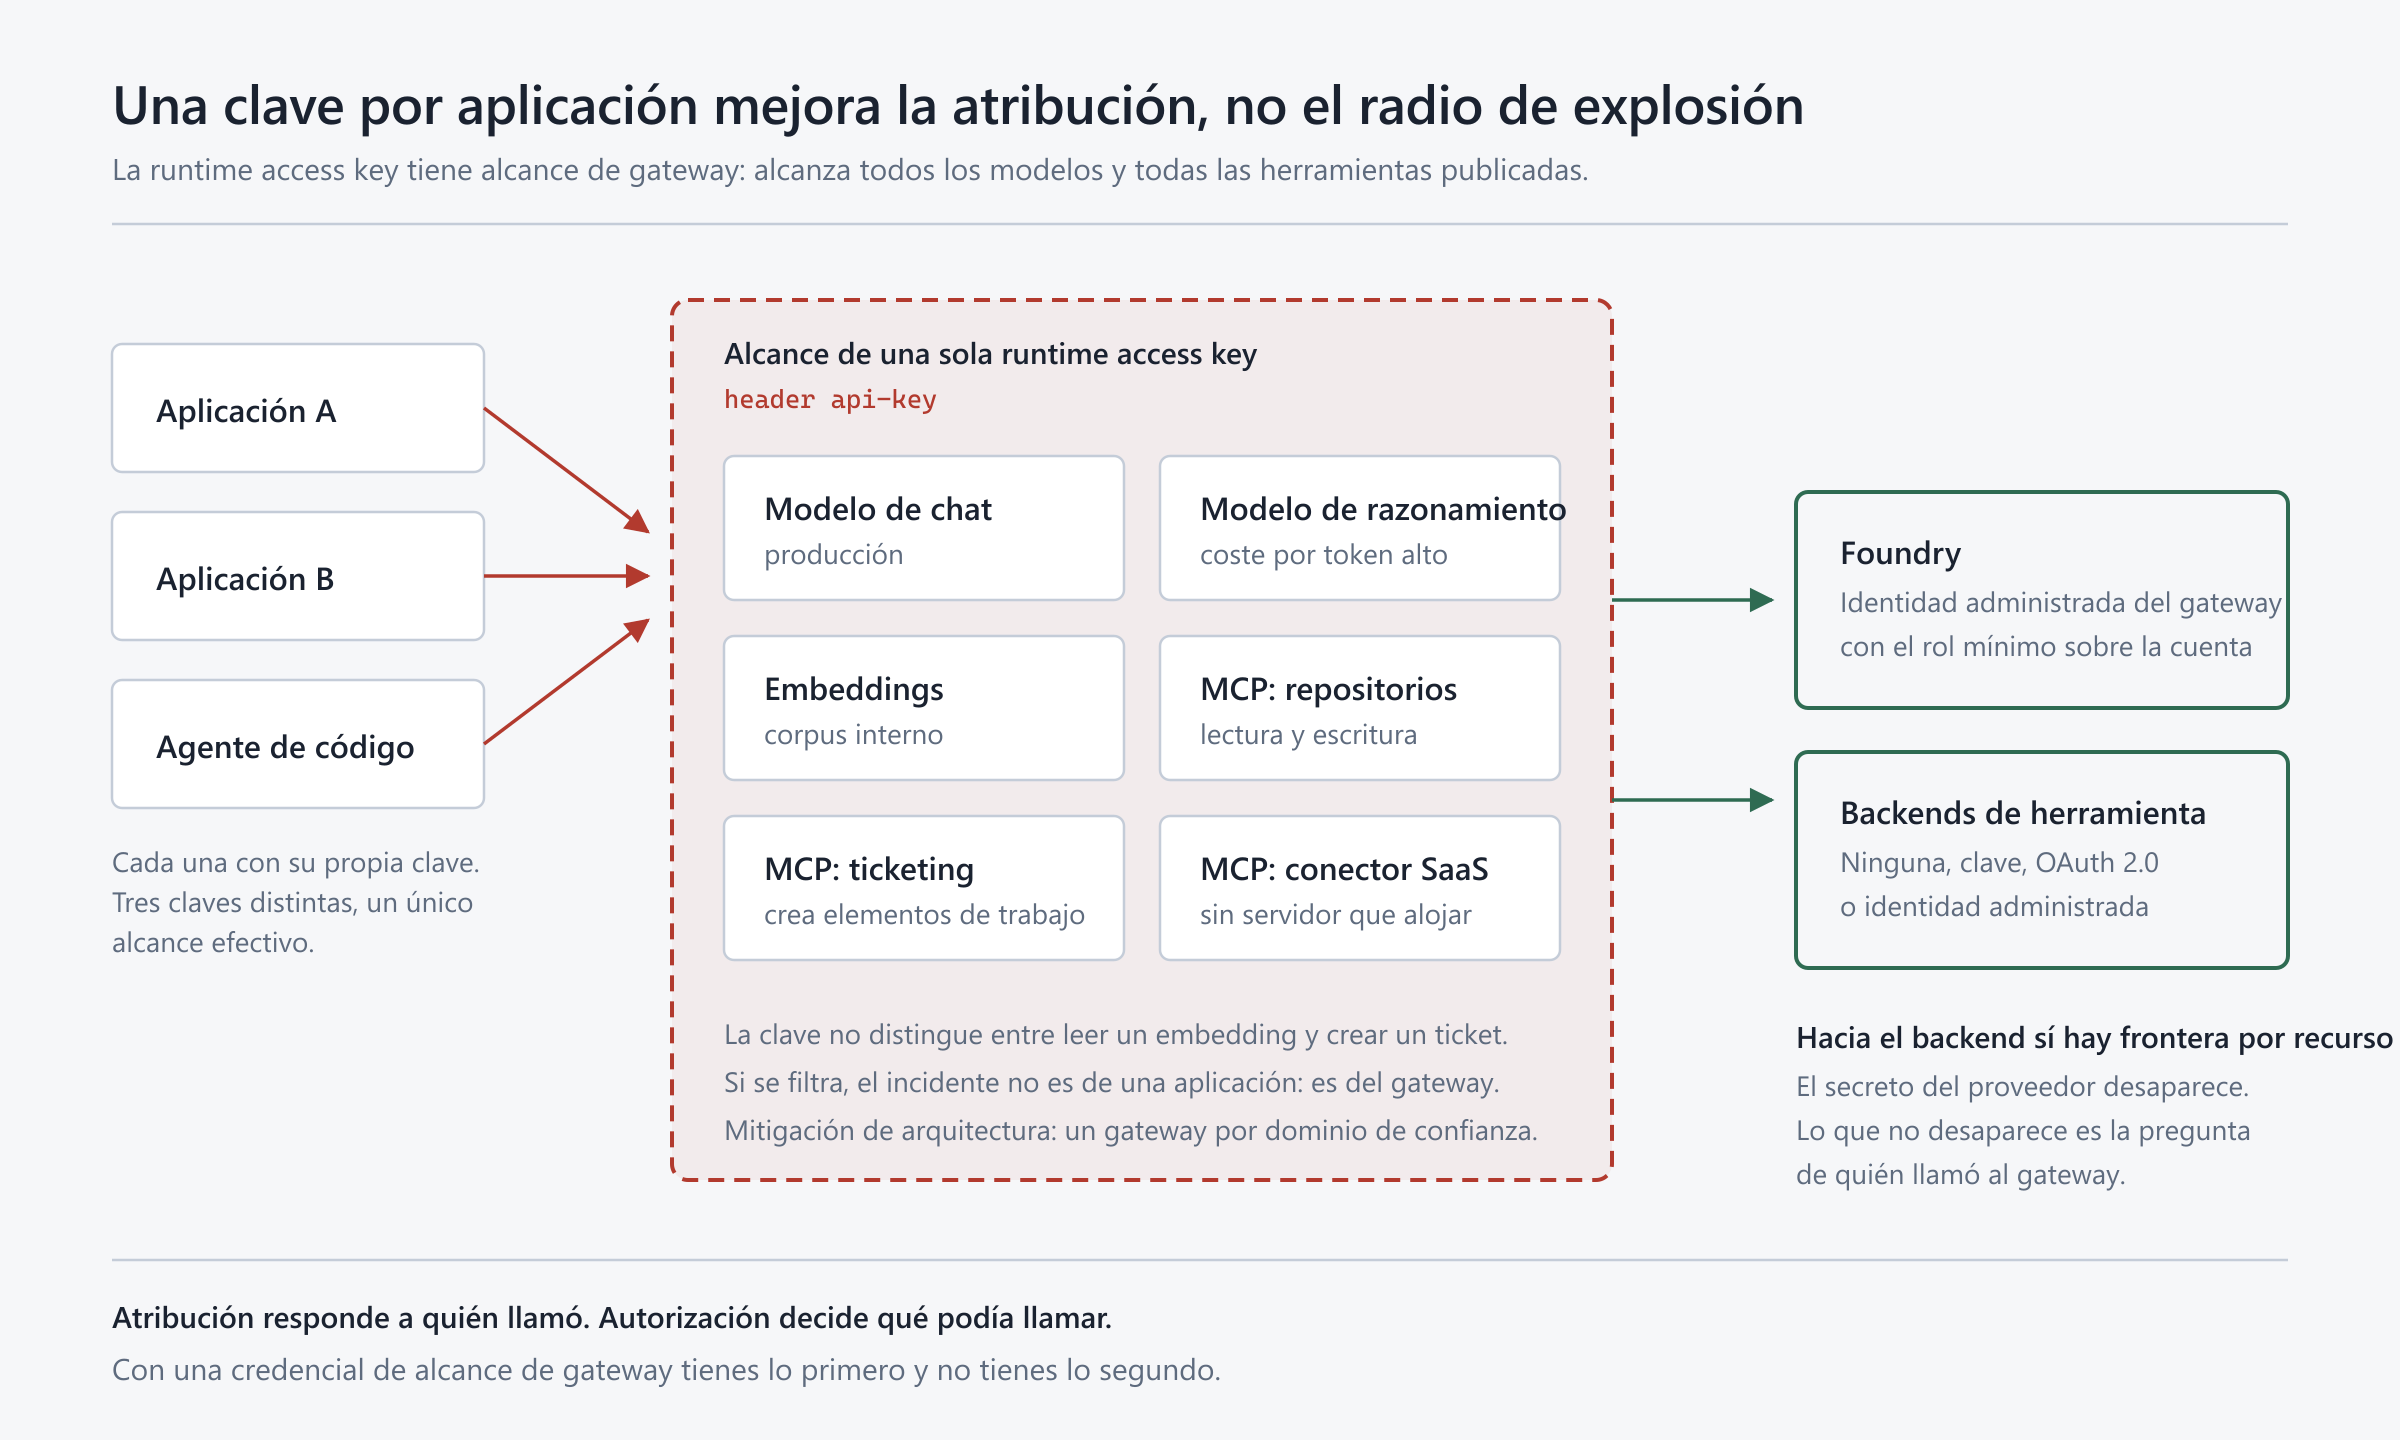
Las aplicaciones se autentican con runtime access keys que se crean en la página de Keys del portal y se envían en el header api-key. Una clave tiene alcance de gateway: alcanza todos los modelos y todas las herramientas. La guía es emitir una clave por aplicación y entorno.
El radio de explosión de una clave filtrada es el gateway completo, no un producto concreto, y quienes hoy usan suscripciones de APIM para acotar consumidores a un conjunto de APIs no van a encontrar aquí esa frontera.
Pongámoslo en una tabla, porque mezclar estos tres planos es el error más caro:
| Credencial | Alcance real | Qué protege | Qué no protege |
|---|---|---|---|
Runtime access key (api-key) |
Todo el gateway: todos los modelos y todas las herramientas MCP publicadas | Que la aplicación no manipule credenciales del proveedor | No acota qué puede invocar quien la posea |
| Identidad administrada del gateway hacia el backend | El recurso backend concreto, con el rol asignado | Las claves del proveedor, que dejan de almacenarse | No dice nada sobre quién llamó al gateway |
| Entra ID en el portal | Plano de gestión | Quién configura modelos, políticas y claves | No es la credencial de runtime |
Y la consecuencia que conviene decir en voz alta:
Una clave por aplicación mejora la atribución y la rotación. No reduce el radio de explosión.
Atribución y autorización no son lo mismo. Saber quién llamó es observabilidad. Decidir qué podía llamar es autorización. Con una credencial de alcance de gateway tienes lo primero y no tienes lo segundo.
Hay señales de que el portal está incorporando autorización basada en Entra ID con asignaciones de rol acotadas a assets concretos, lo cual cerraría justamente este hueco. Antes de construir tu modelo de onboarding encima, verifica cuál de los dos modelos está realmente activo en tu tenant, porque entre uno y otro cambia el diseño completo de segmentación.
Mientras tanto, la mitigación de arquitectura es conocida y poco glamurosa: un gateway por dominio de confianza, no un gateway corporativo único con cincuenta equipos colgando.
Las políticas son controles, no garantías
El filtro de IP funciona, y funciona bien para demostrar que la configuración está viva: dejas de poder invocar el modelo en cuanto tu IP de salida no coincide, aunque tu identidad sea correcta.
Dicho eso, conviene colocar cada tarjeta en su sitio:
- Filtro de IP: control de red. No sabe quién eres. En un mundo con VPN corporativa y salidas NAT compartidas, autoriza a un edificio, no a una aplicación.
- Límite de tokens por minuto: control de ritmo. No es un tope de gasto. Protege la cuota compartida frente a un vecino ruidoso; no impide que un bucle mal escrito consuma durante ocho horas a ritmo legal.
- Content safety: control de contenido sobre prompt y respuesta. No es validación de dominio ni defensa frente a prompt injection indirecta a través de la salida de una herramienta.
- Límite de peticiones: control de volumen, no de coste, porque el coste vive en los tokens.
Ninguna de estas observaciones invalida las políticas. Definen dónde hay que poner las pruebas y qué controles siguen siendo responsabilidad de la aplicación.
Red y residencia
Aquí corrijo algo que circula estos días.
La documentación recoge que la red privada forma parte de la vista previa pública: Private Link de entrada e integración con red virtual de salida, con su propia página de configuración, DNS y limitaciones. Si has leído que el escenario de endpoint privado no existe todavía, contrasta contra la documentación vigente y, sobre todo, contra el escenario exacto que te interesa, que normalmente es el de salida del gateway hacia Foundry con DNS privado.
Y una advertencia que suele llegar tarde a los comités: la residencia del dato depende del camino completo de la petición, no solo de la región del gateway. Hay que revisar dónde están el gateway, los backends, las herramientas, los destinos de logging, las identidades administradas y las aplicaciones cliente.
Lo que el gateway no gobierna
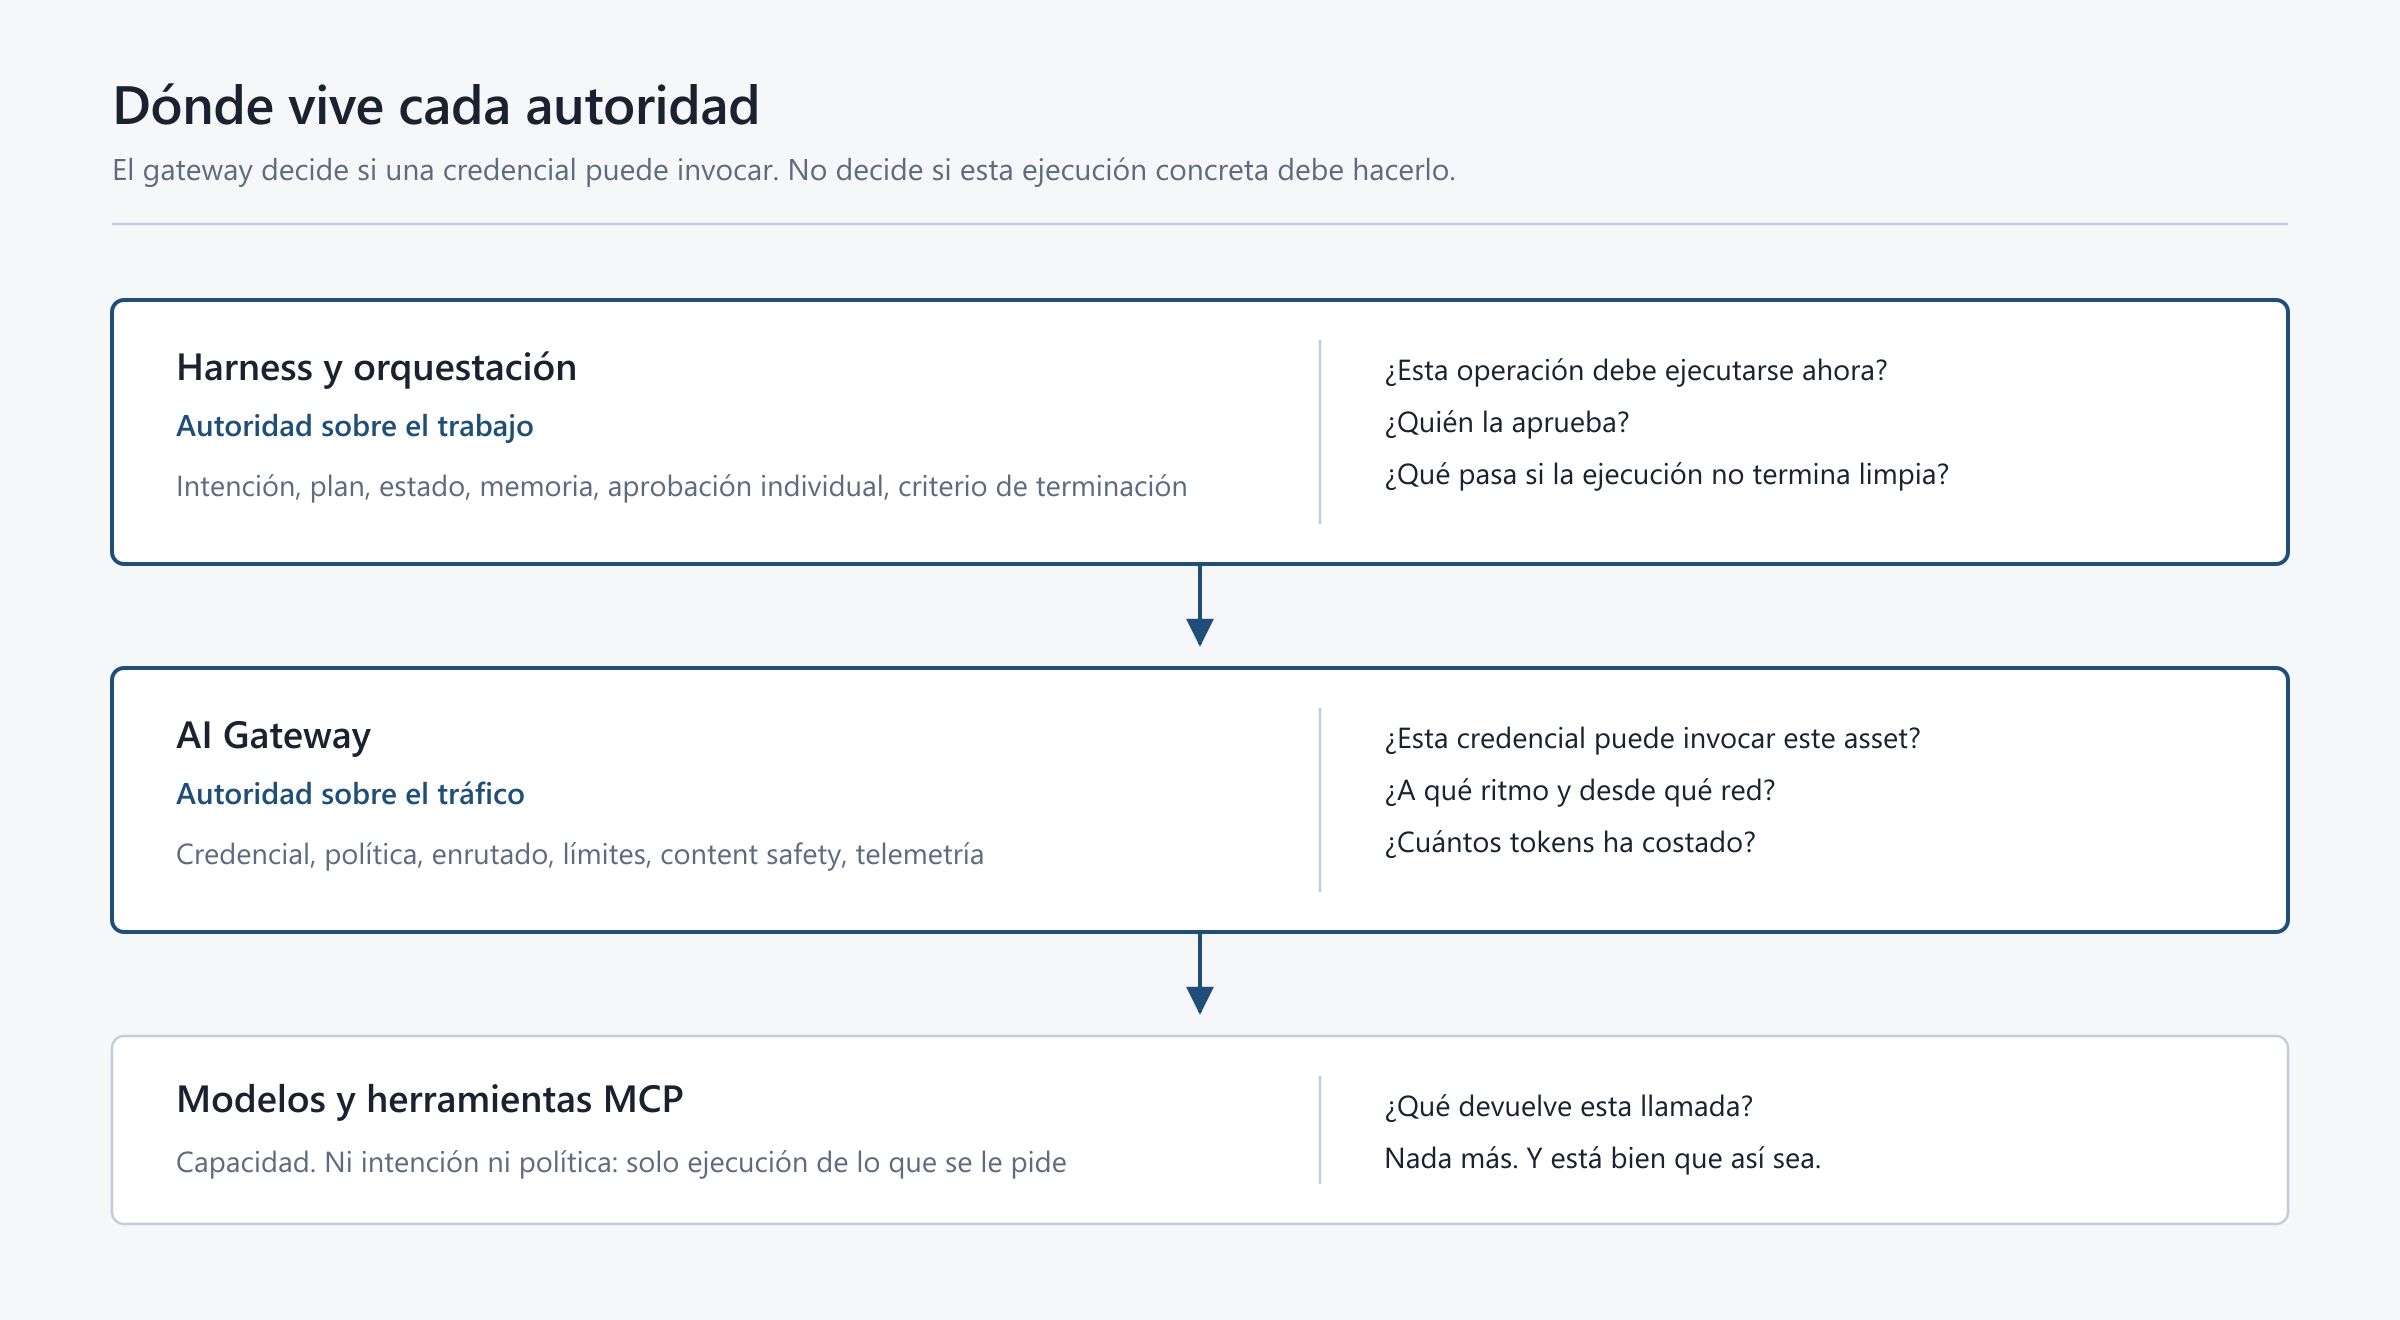
La pregunta más afilada que dejó el lanzamiento no fue sobre rendimiento ni sobre precio: fue qué ocurre cuando la ejecución de un agente produce trabajo útil pero termina sin una finalización limpia, y si esa salida se preserva para revisión auditable o el gateway reintenta. La distinción es entre gobernar tráfico y gobernar el ciclo de vida completo.
El gateway ve peticiones y respuestas. No ve intención, ni plan, ni estado, ni aprobación.
Si una operación con efecto lateral necesita aprobación individual, esa aprobación no puede vivir en el gateway. El gateway puede negar la invocación de una herramienta a una credencial. No puede decidir si esta ejecución concreta, en este estado del plan, debe crear el work item.
Elevate before Delegate sigue aplicando. El gateway es una frontera excelente para delegar. No es el sitio donde se eleva la intención.
Observabilidad
La telemetría sale como logs y métricas OpenTelemetry con las convenciones semánticas GenAI, con el prefijo gen_ai.*, y tú eliges el destino: con Application Insights se queda en tu suscripción, y otros destinos OTLP siguen tu configuración y los términos del proveedor. El recurso se ejecuta en tu propia suscripción y tu tenant de Entra.
Que los tokens estén contados no significa que el proceso haya sido correcto.
Para que esto sea auditoría y no un panel bonito, esas trazas tienen que correlacionarse con la petición de aplicación, la identidad ejecutora, el plan del agente, las herramientas invocadas, las aprobaciones concedidas y los artefactos generados. El trace_id tiene que atravesar la frontera, y eso es trabajo de la aplicación, no del gateway.
Verificar, que no es lo mismo que probar
La demo típica termina cuando el modelo responde. Esa prueba no demuestra casi nada.
El cliente del repositorio comprueba tres cosas distintas:
Console.WriteLine($"modelo solicitado : {result.RequestedModel}");
Console.WriteLine($"modelo que atendio: {result.ServedModel}");

if (result.RoutedElsewhere)
{
    Console.WriteLine("AVISO: el gateway ha enrutado a un modelo distinto del solicitado.");
    Console.WriteLine("Revisa alias y politica de fallback antes de dar la prueba por buena.");
    return 2;
}
Con un alias o una política de fallback configurados, pides un modelo y te atiende otro. La respuesta llega, el contenido es razonable y la prueba parece correcta. No lo es: estás midiendo un modelo que no es el que creías, con un coste por token que tampoco es el que presupuestaste.
La batería de pruebas cubre esa frontera y las de error:
[Fact]
public async Task La_credencial_viaja_en_el_header_api_key_y_no_en_Authorization()
{
    var (client, handler) = Build(HttpStatusCode.OK, StubHandler.Completion("chat-principal"));

    await client.AskAsync("hola");

    var request = Assert.IsType<HttpRequestMessage>(handler.LastRequest);
    Assert.True(request.Headers.Contains("api-key"));
    Assert.Null(request.Headers.Authorization);
}

[Theory]
[InlineData(HttpStatusCode.Unauthorized, "Credencial")]
[InlineData(HttpStatusCode.Forbidden, "Politica de acceso")]
[InlineData(HttpStatusCode.NotFound, "Enrutado")]
[InlineData(HttpStatusCode.TooManyRequests, "Limite")]
public async Task Cada_codigo_de_error_se_traduce_a_su_frontera(HttpStatusCode status, string esperado)
Y contra un entorno real, el script de contrato comprueba las cuatro respuestas que importan: sin credencial, credencial inválida, modelo inexistente y petición correcta con contabilidad de tokens. Un 401 es credencial, un 403 es política de red, un 404 es nombre de modelo y un 429 es límite de ritmo. Cada código señala una frontera distinta, y leerlos así convierte un error en un diagnóstico.
Criterio de decisión
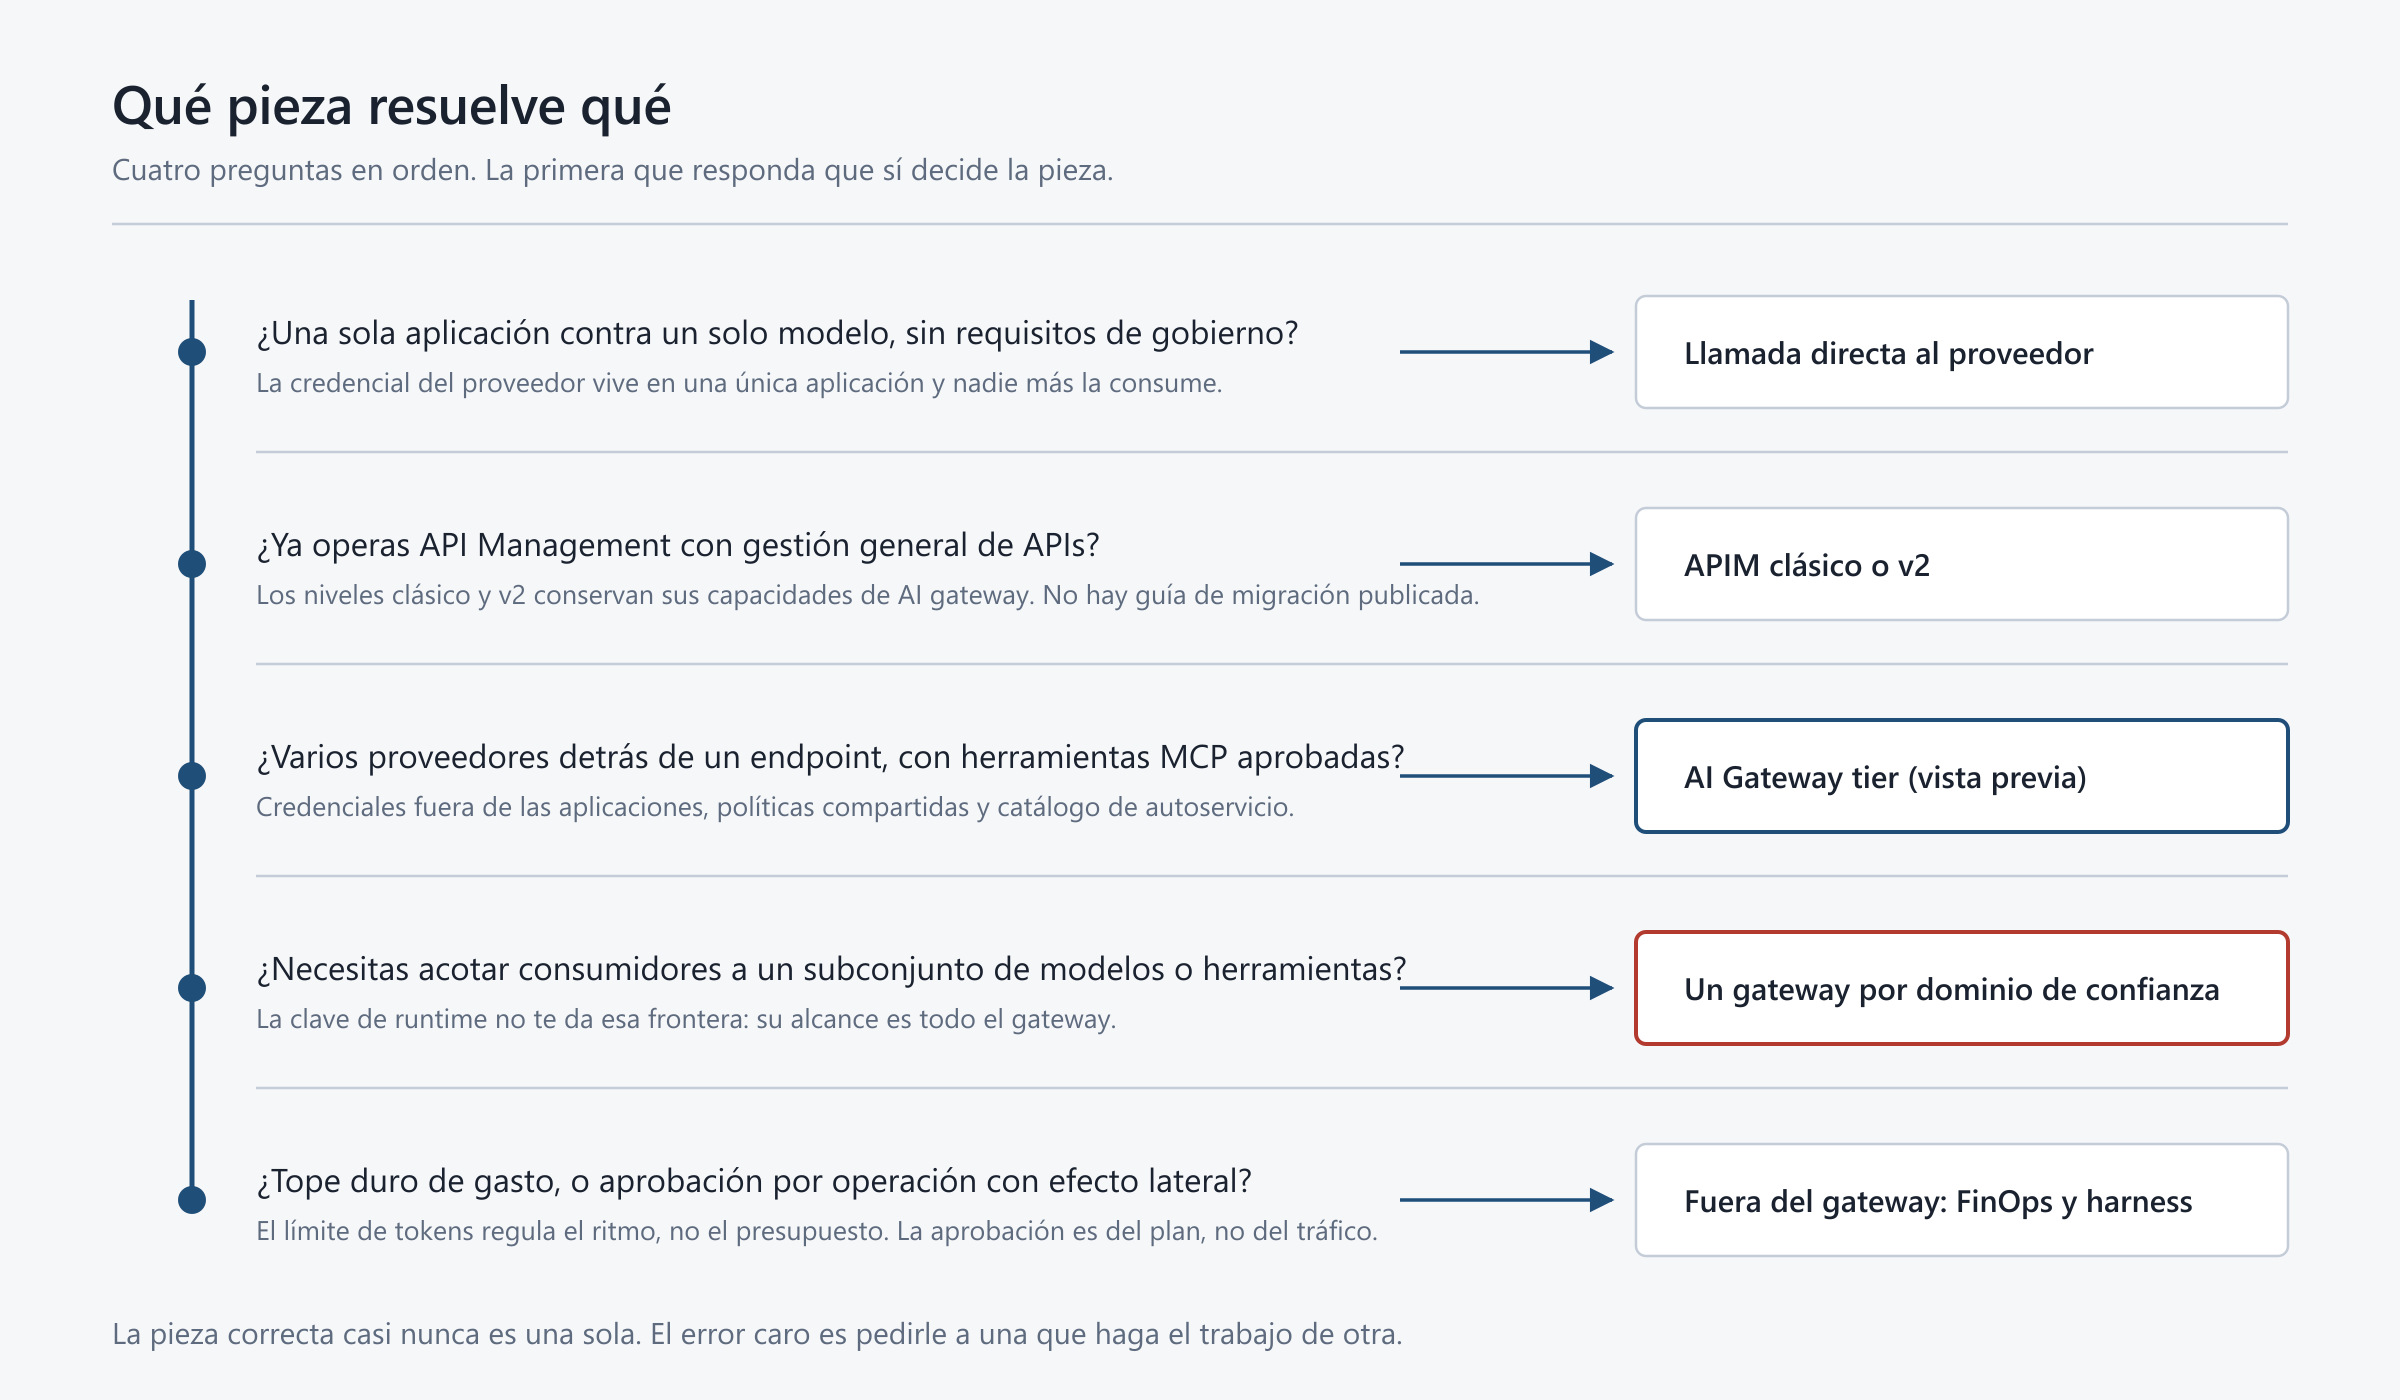
| Escenario | Mecanismo |
|---|---|
| Una aplicación, un modelo, sin requisitos de gobierno | Llamada directa al proveedor |
| Varios proveedores detrás de un endpoint, credenciales fuera de las apps | AI Gateway tier |
| Gobierno de IA junto a gestión general de APIs ya existente | APIM clásico o v2 con capacidades de AI gateway |
| Segmentar consumidores por subconjunto de assets | Hoy: un gateway por dominio de confianza |
| Publicar herramientas MCP aprobadas para agentes | AI Gateway tier |
| Tope duro de gasto por equipo | Fuera del gateway (FinOps, cuota en el proveedor) |
| Aprobación por operación con efecto lateral | Harness / orquestación |
| Trazabilidad extremo a extremo | OTel correlado, no métricas de token aisladas |
Limitaciones actuales
A fecha de 6 de noviembre de 2026:
- La disponibilidad es de mejor esfuerzo, sin SLA, y APIs, flujos del portal, telemetría, límites, regiones y precios pueden cambiar antes de disponibilidad general.
- Está disponible sin coste durante la vista previa en East US 2 y Sweden Central. El precio y el modelo de negocio se anunciarán más adelante dentro de la vista previa, lo que convierte el argumento de gobierno de coste en la parte menos cerrada del lanzamiento.
- Las cuotas de vista previa limitan número de modelos, herramientas y claves de runtime, además del throughput; los límites concretos se publicarán antes de la GA.
- La clave de runtime tiene alcance de gateway.
- El plano de control efectivo es el portal, sobre una API de gestión en preview.
- No hay guía publicada sobre si las inversiones en un gateway de IA montado sobre Premium o Standard v2 conviven, migran o se mantienen en paralelo.
- El nombre del gateway forma parte del endpoint de runtime, con las restricciones de longitud que eso impone. Decídelo con la convención de nombres puesta encima de la mesa, no sobre la marcha.
Estas limitaciones no invalidan el patrón. Delimitan dónde debemos poner las pruebas y dónde no podemos apoyar todavía una decisión de producción.
Conclusión
AI Gateway resuelve un problema real y lo resuelve con una pieza que ya conocemos: un gateway gestionado, en tu suscripción, con telemetría abierta, políticas declaradas como controles y credenciales de proveedor fuera de las aplicaciones.
Lo que no hace, y no debería hacer, es sustituir al plano que decide qué trabajo es legítimo.
La arquitectura correcta no es:
Gateway delante del modeloLa arquitectura correcta es:
Intención elevada arriba
  +
gateway que acota credencial, política y ruta
  +
backends con identidad administrada y mínimo privilegio
  +
aprobación individual para lo que cambia estado
  +
telemetría correlada extremo a extremo
Poner una frontera no es gobernar. Gobernar es saber, en cualquier momento, qué autoridad tenía cada credencial y quién decidió concedérsela.
Ésa es la diferencia entre un gateway desplegado y una plataforma de IA que puedes defender en una auditoría.
Demo y como montar tu primer Azure AI Gateway
Recursos
- AI Gateway tier (preview) overview — Microsoft Learn
- Quickstart: Create an AI Gateway tier (preview) instance — Microsoft Learn
- Manage models and tools in AI Gateway tier (preview) — Microsoft Learn
- Get started with the AI Gateway tier setup wizard — Microsoft Learn
- AI Gateway tier of API Management now in public preview — Tech Community
- Azure/ai-gateway — GitHub